¿Qué hace falta saber de Python, de álgebra matricial y de probabilidad para leer el resto del libro, y dónde se usa cada cosa?
Leer y escribir el código del libro: NumPy, pandas, matplotlib, funciones y clases.
Repasar el álgebra matricial que sostiene a los VAR: productos, potencias, autovalores, Cholesky, Kronecker y el operador vec.
Simular de las distribuciones que usa el libro y entender, en su versión más simple, el Monte Carlo y el bootstrap.
Requisitos previos. Un curso de álgebra lineal y uno de estadística. No hace falta haber programado en Python.
Serie
Fuente
Frecuencia
Código
Índice de precios al consumidor de EE.UU. (sin desestacionalizar)
FRED
mensual
CPIAUCNS
Índice de precios del gasto de consumo personal (PCE)
FRED
mensual
PCEPI
Series simuladas
este capítulo
Todo lo demás se simula con semilla fija, de modo que cada número del texto se reproduce exactamente al ejecutar el código.
0.1 Cómo leer este capítulo
Este capítulo no es un curso de Python ni de álgebra lineal. Los hay excelentes y gratuitos, y se citan a lo largo del texto. Es un repaso dirigido: para escribirlo se recorrieron los capítulos del libro, se anotó cada herramienta que dan por sabida y se reunieron aquí, en el orden en que conviene aprenderlas, con un ejemplo que se puede ejecutar y un enlace al lugar donde se vuelven a usar.
Se puede leer de dos maneras. Quien empieza con Python conviene que lo lea de corrido, ejecutando cada celda. Quien ya programa puede usarlo como referencia: cada capítulo abre con una línea de requisitos previos que enlaza con la sección de este capítulo que la cubre.
Qué herramienta se repasa dónde y en qué capítulo se usa
que es el VAR del capítulo 3 con una sola variable. Si \(|\phi| < 1\), el proceso es estacionario, con media \(\mu = c/(1-\phi)\) y varianza \(\sigma^2/(1-\phi^2)\). Cada sección le aplica una herramienta: se simula con un bucle, se estima por mínimos cuadrados con matrices, se estudia su estabilidad con autovalores y se construye su distribución muestral por bootstrap; el capítulo 2 lo estima además con un muestreador de Gibbs. Quien entiende el AR(1) con estas herramientas ya entiende el VAR: es el mismo cálculo con matrices en lugar de escalares.
0.2 Python en lo esencial
El entorno del libro se instala con uv, que descarga la versión correcta de Python y fija la de cada paquete: uv sync en la carpeta del repositorio y uv run jupyter lab para trabajar en cuadernos. La presentación del libro explica los detalles. Todo el código se puede ejecutar celda por celda, en el orden en que aparece.
Python tiene pocos tipos básicos y conviene conocerlos antes que nada. Los números y las cadenas de texto se comportan como se espera; las listas guardan secuencias que pueden cambiar; las tuplas, secuencias fijas; y los diccionarios asocian claves con valores, que es como se pasan opciones con nombre.
La primera línea impresa resume las dos convenciones que más confunden a quien llega de MATLAB: los índices empiezan en cero, de modo que lags[0] es el primer elemento, y los cortes a:bincluyen a y excluyen b. El índice -1 es el último elemento. En series de tiempo esto importa todo el tiempo: y[1:] son las observaciones de la 2 a la \(T\) y y[:-1] las de la 1 a la \(T-1\), justo los dos vectores que se alinean para regresar \(y_t\) sobre \(y_{t-1}\).
Una recursión se escribe con un buclefor, y un bloque de código que se va a reutilizar se envuelve en una función. La función de abajo simula el AR(1): recibe los parámetros, crea un generador de números aleatorios con semilla (se discute en la sección 0.10) y recorre el tiempo aplicando la ecuación del modelo.
import numpy as npdef simulate_ar1(c, phi, sigma, T, seed=None):"""Simulate y_t = c + phi y_{t-1} + sigma e_t, e_t ~ N(0,1). The first value is the unconditional mean, so the path starts in the stationary region when |phi| < 1. """ rng = np.random.default_rng(seed) y = np.empty(T) y[0] = c / (1- phi)for t inrange(1, T): shock = sigma * rng.standard_normal() y[t] = c + phi * y[t -1] + shockreturn yc, phi, sigma =0.5, 0.8, 1.0y = simulate_ar1(c, phi, sigma, T=200, seed=11)mean_theory = c / (1- phi)var_theory = sigma**2/ (1- phi**2)print(f"media: {y.mean():.2f} (teórica {mean_theory:.2f})")print(f"varianza: {y.var():.2f} (teórica {var_theory:.2f})")
Con 200 observaciones, la media muestral queda cerca de la teórica, pero la varianza queda un 20 % por debajo. No hay error en el código: con \(\phi = 0.8\) cada observación trae poca información nueva respecto de la anterior, y la muestra efectiva es mucho menor que 200. Es la primera aparición de un tema que vuelve en todo el libro, el de la persistencia como enemiga de la precisión.
Tres detalles de la función se repiten en todo el código del libro. La cadena entre comillas triples es la documentación (docstring), que se consulta con help(simulate_ar1). Los argumentos con valor por defecto, como seed=None, son opcionales y se pasan por nombre. Y la función devuelve un resultado en lugar de imprimirlo, de modo que se puede seguir usando.
NumPy (Harris et al. 2020) es la base de todo el cálculo numérico en Python. Su objeto central es el arreglo (ndarray): una tabla de números de un solo tipo, con una forma (shape) que dice cuántas dimensiones tiene y cuántos elementos hay en cada una.
a = np.array([1.0, 2.0, 3.0]) # 1-D, shape (3,)A = np.array([[2.0, 1.0], [1.0, 3.0]]) # 2-D, shape (2, 2)b = np.array([1.0, 2.0])print(a.shape, A.shape)print("A * A =", (A * A).ravel()) # element by elementprint("A @ A =", (A @ A).ravel()) # matrix productprint("A' b =", A.T @ b)print("x: A x = b ->", np.linalg.solve(A, b))
(3,) (2, 2)
A * A  = [4. 1. 1. 9.]
A @ A  = [ 5.  5.  5. 10.]
A' b   = [4. 7.]
x: A x = b -> [0.2 0.6]
Cuatro operaciones cubren casi todo el libro. El producto matricial se escribe @; el asterisco * multiplica elemento por elemento. La transpuesta es .T. Para resolver un sistema \(Ax = b\) se usa np.linalg.solve(A, b), no np.linalg.inv(A) @ b: el resultado es el mismo en aritmética exacta, pero solve es más rápido y numéricamente más estable, porque no calcula una inversa que no hace falta. Y la difusión (broadcasting) permite operar arreglos de formas distintas cuando una dimensión vale uno: X - X.mean(axis=0) resta a cada columna su media sin escribir un bucle.
Con eso se escribe el estimador de mínimos cuadrados. Apilando la ecuación del AR(1) para \(t = 2, \ldots, T\),
con varianza estimada \(\hat{\sigma}^2 (X'X)^{-1}\), donde \(\hat{\sigma}^2\) es la suma de residuos al cuadrado dividida por \(T - 1 - 2\). En código:
La estimación está cerca de los valores con que se simuló, \(c = 0.5\) y \(\phi = 0.8\), y a menos de un error estándar de cada uno. El VAR del capítulo 3 se estima con esta misma fórmula: como todas las ecuaciones comparten los regresores \(X\), basta reemplazar el vector \(Y\) por la matriz que tiene una columna por variable, \(\hat{B} = (X'X)^{-1}X'Y\).
Los bucles de Python son lentos comparados con las operaciones de NumPy, que se ejecutan en código compilado. Por eso se vectoriza: se reemplaza un bucle sobre elementos por una operación sobre el arreglo entero.
import timebig = simulate_ar1(c, phi, sigma, T=100_000, seed=2)start = time.perf_counter()total =0.0for value in big: total += value * valueloop_time = time.perf_counter() - startstart = time.perf_counter()total_vec = big @ bigvec_time = time.perf_counter() - startprint(f"mismo resultado: {np.isclose(total, total_vec)}")print(f"el bucle tarda {loop_time / vec_time:.0f} veces más")
mismo resultado: True
el bucle tarda 79 veces más
La proporción exacta depende de la máquina y cambia de una ejecución a otra, pero ronda los dos órdenes de magnitud a favor de la versión vectorizada. No todo se puede vectorizar: una recursión como la del AR(1) necesita el valor anterior para calcular el siguiente, y ahí el bucle es la forma natural de escribirla. La regla práctica es escribir primero la versión clara y vectorizar sólo lo que de verdad pesa.
Un arreglo de una dimensión no es un vector columna ni un vector fila: no tiene orientación, y a.T lo deja igual. Si hace falta un vector columna, a.reshape(-1, 1) lo construye; si hace falta el producto exterior \(aa'\), np.outer(a, a). Confundir * con @ es el otro error clásico, y no siempre da un error de forma: con matrices cuadradas ambos productos funcionan y dan resultados distintos.
Todo depende entonces de qué pasa con las potencias\(A^j\). Si convergen a cero, la condición inicial se olvida y un choque de hace \(j\) periodos pesa cada vez menos. Si no convergen, el sistema no vuelve nunca a su media.
La herramienta para saberlo son los autovalores (o valores propios). Un escalar \(\lambda\) y un vector \(v \neq 0\) son autovalor y autovector de \(A\) si \(Av = \lambda v\): en la dirección \(v\), multiplicar por \(A\) equivale a multiplicar por \(\lambda\). Si \(A\) tiene \(n\) autovectores independientes, reunidos en las columnas de \(V\), se puede escribir \(A = V \Lambda V^{-1}\) con \(\Lambda\) diagonal, y entonces
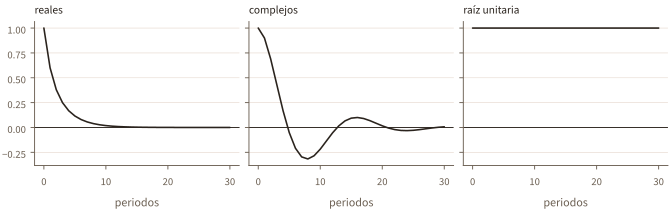
Las potencias de \(A\) se reducen a potencias de escalares. De ahí sale la condición de estabilidad: \(A^j \to 0\) si y sólo si todos los autovalores tienen módulo menor que uno, es decir si el radio espectral\(\rho(A) = \max_i |\lambda_i|\) es menor que uno. Si un autovalor es complejo, \(\lambda = r e^{\pm i\omega}\), su potencia \(r^j e^{\pm i\omega j}\) gira mientras se achica: la respuesta oscila con periodo \(2\pi/\omega\) y se amortigua al ritmo \(r^j\). Los VAR macroeconómicos suelen tener autovalores complejos, y por eso sus respuestas al impulso tienen forma de joroba o de onda.
Figura 1: Respuesta de la primera variable a un choque unitario en ella misma, \((A^j)_{11}\), para las tres matrices. Con autovalores reales la respuesta decae sin cambiar de signo; con autovalores complejos oscila mientras se amortigua; con un autovalor igual a uno no vuelve a cero.
Un AR(2) se analiza igual, después de escribirlo como un VAR(1) en el vector \((y_t, y_{t-1})'\). La matriz de ese sistema es la companion, y sus autovalores son las raíces inversas del polinomio de rezagos:
autovalores: [0.65+0.421j 0.65-0.421j]
módulo 0.775, periodo 10.9
Con \(\phi_1 = 1.3\) y \(\phi_2 = -0.6\) los autovalores son complejos de módulo 0.775: el proceso es estable y sus ciclos duran unos once periodos, que en datos trimestrales es la duración de un ciclo económico corto. Así se lee la estabilidad de un VAR(\(p\)) en el capítulo 3: se escribe en forma companion y se miran los autovalores de \(F\). Las respuestas al impulso del capítulo 4 son exactamente las potencias \(F^j\), recortadas por la matriz de selección \(J\).
Los autovalores de una matriz no simétrica pueden ser complejos: el módulo se calcula con np.abs, no con el valor absoluto de la parte real, y NumPy no los devuelve en ningún orden particular. Para matrices simétricas, como una covarianza, conviene np.linalg.eigh, que es más rápida, garantiza autovalores reales y los ordena de menor a mayor.
La lección Eigenvalues and Eigenvectors de QuantEcon desarrolla la intuición geométrica con más detalle, y el apéndice A de Lütkepohl (2005) reúne los resultados de álgebra matricial que usan los VAR.
0.5 Determinantes y factorizaciones
El determinante de una matriz cuadrada es el producto de sus autovalores, \(\det(A) = \prod_i \lambda_i\), y mide cuánto multiplica \(A\) los volúmenes. Una matriz es invertible si y sólo si su determinante no es cero. En el libro aparece en dos lugares: en la condición de estabilidad del VAR, que el capítulo 3 escribe como \(\det(I_n - \Phi_1 z - \cdots - \Phi_p z^p) \neq 0\) para \(|z| \leq 1\), y en la densidad de la normal multivariada, donde \(|\Sigma|^{-1/2}\) ajusta la escala.
Casi nunca hace falta el determinante en sí, sino su logaritmo, y conviene calcularlo sin pasar por el determinante: con muchas variables, \(\det(\Sigma)\) puede ser tan grande o tan pequeño que se sale del rango de los números de máquina, mientras que su logaritmo no. Ahí entra la factorización más útil del libro.
Cholesky. Toda matriz simétrica definida positiva, como una covarianza, se escribe de una única manera como
\[ \Sigma = L L', \]
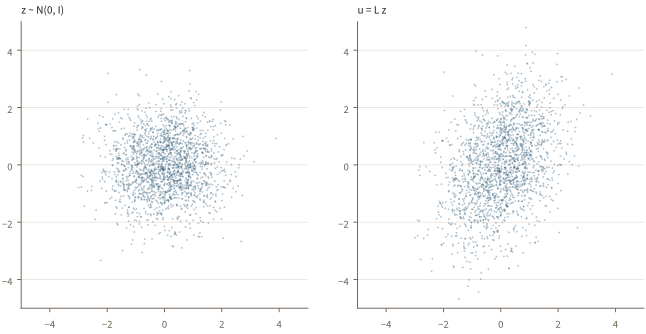
con \(L\) triangular inferior y diagonal positiva. Es la raíz cuadrada de una matriz. Sirve para tres cosas. La primera, calcular \(\log|\Sigma| = 2\sum_i \log L_{ii}\) sin riesgo numérico. La segunda, simular: si \(z \sim N(0, I)\), entonces \(u = Lz\) tiene covarianza \(\mathbb{E}[Lzz'L'] = LL' = \Sigma\). La tercera, que es la del capítulo 4: esa misma identidad, escrita \(\mathbf{u}_t = S\varepsilon_t\) con \(S = L\), es la identificación recursiva de un VAR estructural.
Sigma = np.array([[1.0, 0.5], [0.5, 2.0]])L = np.linalg.cholesky(Sigma)print("L =\n", np.round(L, 3))sign, logdet = np.linalg.slogdet(Sigma)print(f"log|Sigma|: {logdet:.4f} (slogdet), "f"{2* np.log(np.diag(L)).sum():.4f} (Cholesky)")rng = np.random.default_rng(3)z = rng.standard_normal((100_000, 2))u = z @ L.T # each row is L z_tprint("covarianza simulada:\n", np.round(np.cov(u.T), 3))
Figura 2: Dos mil extracciones de una normal estándar bivariada (izquierda) y las mismas extracciones multiplicadas por el factor de Cholesky de \(\Sigma\) (derecha). \(L\) estira la nube en la dirección de la segunda variable y la inclina según la correlación.
Matrices ortogonales. Una matriz \(Q\) es ortogonal si \(QQ' = I\): rota o refleja sin cambiar longitudes. Si \(\Sigma = LL'\), entonces para cualquier \(Q\) ortogonal
\[ (LQ)(LQ)' = L\,QQ'\,L' = LL' = \Sigma , \]
de modo que \(LQ\) es otra “raíz cuadrada” igual de válida. La descomposición \(QR\) de una matriz de normales independientes produce una \(Q\) ortogonal extraída al azar de manera uniforme, con una corrección de signos para que la distribución sea exactamente la uniforme:
Q Q' = I: True
S S' = Sigma: True
S =
 [[-0.365  0.931]
 [ 1.049  0.948]]
Esas líneas son el problema de identificación del capítulo 4 en miniatura. La covarianza de los residuos no distingue entre \(L\) y \(LQ\), así que los datos solos no dicen cuál es la matriz de impacto correcta. La identificación recursiva elige \(L\); las restricciones de signo recorren muchas \(Q\) y se quedan con las que producen respuestas de signo razonable.
0.6 Producto de Kronecker y el operador vec
Dos operaciones permiten escribir un sistema de ecuaciones como una sola regresión, y el capítulo 5 no se entiende sin ellas.
El operador \(\operatorname{vec}\) apila las columnas de una matriz en un solo vector:
\[ \operatorname{vec}\begin{bmatrix} a & c \\ b & d \end{bmatrix} = \begin{bmatrix} a \\ b \\ c \\ d \end{bmatrix} . \]
El producto de Kronecker de \(A\) (\(m \times n\)) y \(B\) (\(p \times q\)) es la matriz de bloques \(mp \times nq\) que multiplica cada elemento de \(A\) por la matriz \(B\) entera:
\[ A \otimes B = \begin{bmatrix} a_{11} B & \cdots & a_{1n} B \\ \vdots & \ddots & \vdots \\ a_{m1} B & \cdots & a_{mn} B \end{bmatrix} . \]
Cuatro reglas bastan para todo el libro:
\[ (A \otimes B)(C \otimes D) = AC \otimes BD, \quad (A \otimes B)^{-1} = A^{-1} \otimes B^{-1}, \quad (A \otimes B)' = A' \otimes B', \]
La última es la que se usa: con \(A = X\), \(B\) la matriz de coeficientes y \(C = I_n\), dice que \(\operatorname{vec}(XB) = (I_n \otimes X)\operatorname{vec}(B)\). Aplicada a \(Y = XB + U\), convierte el VAR en la regresión \(y = (I_n \otimes X)\,b + u\) sobre el vector de todos los coeficientes, que es donde el capítulo 5 pone el prior.
def vec(M):"""Stack the columns of M (column-major order)."""return M.flatten(order="F")rng = np.random.default_rng(5)A = rng.standard_normal((2, 3))B = rng.standard_normal((3, 4))C = rng.standard_normal((4, 2))left = vec(A @ B @ C)right = np.kron(C.T, A) @ vec(B)print("vec(ABC) = (C' kron A) vec(B):", np.allclose(left, right))M = np.array([[1, 2, 3], [4, 5, 6]])print("vec(M): ", vec(M))print("M.flatten(): ", M.flatten())
NumPy guarda y recorre las matrices por filas, y \(\operatorname{vec}\) apila columnas. M.flatten() devuelve las filas una tras otra y no es \(\operatorname{vec}(M)\); hay que escribir M.flatten(order="F"), y para volver atrás, reshape(..., order="F"). El error es silencioso: las formas coinciden y el resultado está mal. En el capítulo 5 todas las conversiones entre \(B\) y \(b\) llevan order="F" por esta razón.
Un producto de Kronecker crece rápido: \(\Sigma \otimes I_T\) con siete variables y 200 observaciones es una matriz de \(1400 \times 1400\). Las fórmulas del libro están escritas para no formarlo nunca, aprovechando la primera regla: \(\Sigma^{-1} \otimes X'X\) es sólo de \(nk \times nk\).
0.7 Series y fechas con pandas
pandas (McKinney 2010) agrega a NumPy lo que falta para trabajar con datos: nombres para las columnas y, sobre todo, un índice que en series de tiempo son las fechas. Sus dos objetos son la Series, una columna con índice, y el DataFrame, una tabla de columnas que comparten el índice.
import pandas as pdfrom macrobook import data_pathusa = pd.read_csv(data_path("us_monthly.csv"), index_col="date")usa.index = pd.PeriodIndex(usa.index, freq="M")cpi = usa["cpi_nsa"] # CPI, not seasonally adjustedprint(type(usa).__name__, usa.shape)print(cpi.tail(3))print("meses sin dato:", list(cpi.index[cpi.isna()]))
DataFrame (1364, 4)
date
2026-06    333.952
2026-07    333.918
2026-08    334.980
Freq: M, Name: cpi_nsa, dtype: float64
meses sin dato: [Period('2025-10', 'M')]
El índice es un PeriodIndex de frecuencia mensual: cada elemento representa un mes entero, no un instante. Es la representación natural de datos macroeconómicos, que son flujos o promedios de un periodo. La alternativa, un DatetimeIndex, representa instantes, y es la que piden algunas funciones y los gráficos; se pasa de una a otra con .to_timestamp() y .to_period(). La aritmética con periodos respeta el calendario, de modo que sumar doce meses a abril de 2021 da abril de 2022.
El índice de precios tiene un hueco: octubre de 2025, cuando el cierre del gobierno federal impidió a la Oficina de Estadísticas Laborales recoger los precios. pandas lo guarda como NaN y la fila sigue ahí, que es lo que conviene.
Las transformaciones del capítulo 1 son operaciones de una línea. shift(k) desplaza la serie \(k\) periodos, de modo que cpi / cpi.shift(12) divide cada mes por el mismo mes del año anterior; np.log(cpi).diff() es la diferencia logarítmica; y la selección por fechas funciona con cadenas, cpi["2000":]. Para cambiar de frecuencia se usa resample, y para agrupar por una característica de la fecha, groupby.
infl_yoy =100* (cpi / cpi.shift(12) -1)infl_mom =100* np.log(cpi).diff()cpi_q = cpi.resample("Q").mean()recent = infl_mom["2000":]by_month = recent.groupby(recent.index.month).mean()print(f"inflación interanual, {infl_yoy.index[-1]}: "f"{infl_yoy.iloc[-1]:.2f} %")print(f"IPC trimestral: {len(cpi_q)} trimestres, "f"el último {cpi_q.index[-1]}")print("variación mensual media por mes desde 2000 (%):")print(by_month.round(2).to_string())
inflación interanual, 2026-08: 3.40 %
IPC trimestral: 455 trimestres, el último 2026Q3
variación mensual media por mes desde 2000 (%):
date
1     0.42
2     0.46
3     0.56
4     0.38
5     0.33
6     0.28
7     0.09
8     0.15
9     0.21
10    0.02
11   -0.18
12   -0.17
El promedio por mes es la versión más cruda de un factor estacional. Desde 2000, los precios suben más en los primeros meses del año y bajan en noviembre y diciembre, con las liquidaciones de fin de año y el ciclo de la gasolina. El capítulo 1 explica cómo estimar ese factor con métodos que permiten que cambie de un año a otro.
shift desplaza por posición, no por fecha. Si antes se borra el mes faltante con dropna(), cada mes entre noviembre de 2025 y octubre de 2026 queda comparado con el mes equivocado del año anterior, sin ningún aviso. Con el hueco en su lugar, la inflación interanual sale NaN en los dos meses que dependen de octubre de 2025, que es la respuesta correcta.
compact = cpi.dropna()wrong =100* (compact / compact.shift(12) -1)error = (wrong - infl_yoy).abs()["2025-11":"2026-10"]print(f"error máximo por usar dropna: {error.max():.2f} "f"puntos, en {error.idxmax()}")
error máximo por usar dropna: 0.67 puntos, en 2026-01
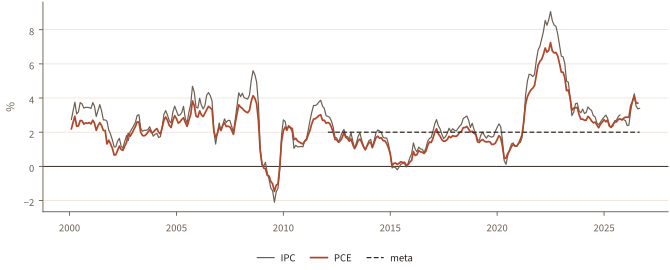
Un último ejemplo combina fechas y selección lógica. En enero de 2012 la Reserva Federal anunció por primera vez una meta numérica: 2 % de inflación interanual, medida con el índice de precios del gasto de consumo personal (PCE) y no con el IPC (Federal Open Market Committee 2012). Con las dos series en el mismo DataFrame se comparan mes a mes:
pce_yoy =100* (usa["pce_price"] / usa["pce_price"].shift(12)-1)before = pce_yoy["2012":"2020"]after = pce_yoy["2021":].dropna()gap = (infl_yoy - pce_yoy)["2000":].mean()print(f"2012-2020, bajo la meta: {(before <2).mean():.0%}")print(f"desde 2021, sobre la meta: {(after >2).mean():.0%}")print(f"máximo: {after.max():.1f} % en {after.idxmax()}")print(f"IPC menos PCE, promedio desde 2000: {gap:.2f} puntos")
2012-2020, bajo la meta: 89%
desde 2021, sobre la meta: 97%
máximo: 7.2 % en 2022-06
IPC menos PCE, promedio desde 2000: 0.36 puntos
Los dos tramos cuentan historias opuestas. Entre 2012 y 2020 la inflación estuvo por debajo de la meta en casi nueve de cada diez meses; desde 2021 estuvo por encima en casi todos, con un máximo de 7.2 % en junio de 2022. Y la elección del índice no es un detalle: desde 2000 la inflación del IPC supera en promedio a la del PCE en 0.36 puntos, de modo que medir la meta con el IPC cambiaría el diagnóstico: haría ver menor el incumplimiento por abajo de 2012-2020 y mayor el de arriba desde 2021.
matplotlib (Hunter 2007) dibuja con dos objetos: la figura, que es el lienzo, y los ejes, que son cada panel. plt.subplots(filas, columnas) crea ambos, y después se dibuja llamando a los métodos de cada eje: ax.plot, ax.fill_between, ax.set_title. Trabajar siempre con los ejes explícitos, en lugar de las funciones sueltas de plt, evita la mayoría de las sorpresas cuando hay más de un panel.
El libro agrega tres convenciones, reunidas en el paquete macrobook. use_style() aplica una sola hoja de estilo a todas las figuras, de modo que ningún capítulo elige tipografías ni colores por su cuenta. figsize(ratio) devuelve el tamaño de la figura como una proporción del ancho de la columna, que es distinto en la web y en el PDF. Y PALETTE y charts reúnen los colores y los gráficos que se repiten: líneas de referencia, leyendas, bandas, abanicos.
Figura 3: Inflación interanual de Estados Unidos medida con el IPC y con el índice PCE, y la meta de 2 % de la Reserva Federal, explícita desde enero de 2012 y definida sobre el PCE.
El código del libro vive en dos lugares con dos estilos distintos, y conviene reconocerlos.
El paquete macrobook, que acompaña al libro, está hecho de funciones agrupadas en módulos: var para la mecánica del VAR, svar para la identificación y el análisis estructural, bvar para el VAR bayesiano. Cada función hace un solo paso, recibe arreglos y devuelve arreglos. Es el estilo que conviene para aprender, porque cada paso del algoritmo queda a la vista.
from macrobook import varfit = var.ols(y.reshape(-1, 1), p=1) # a VAR(1) with n = 1print(sorted(fit))print("B =", np.round(fit["B"].ravel(), 3))
El VAR de una variable y un rezago es el AR(1), y la función del capítulo 3 devuelve los mismos coeficientes que se calcularon a mano en la sección 0.3, con la constante en la primera fila de \(B\).
MacroPy, la biblioteca que el libro usa como tercer nivel, está hecha de clases. Una clase agrupa datos y las operaciones sobre esos datos: se construye un objeto una vez, con los datos y las opciones, y después se le piden cosas. Lo que el objeto sabe son sus atributos; lo que sabe hacer, sus métodos. Una clase mínima para el AR(1) muestra el patrón:
class AR1:"""AR(1) with an intercept, estimated by OLS."""def__init__(self, y):self.y = np.asarray(y, dtype=float)def fit(self): X = np.column_stack([np.ones(len(self.y) -1),self.y[:-1]])self.c, self.phi = np.linalg.solve( X.T @ X, X.T @self.y[1:])returnself# allows chainingdef forecast(self, h): path, last = [], self.y[-1]for _ inrange(h): last =self.c +self.phi * last path.append(last)return np.array(path)model = AR1(y).fit()print(f"phi = {model.phi:.3f}")print("pronóstico:", np.round(model.forecast(4), 2))
phi = 0.783
pronóstico: [1.16 1.47 1.71 1.89]
__init__ se ejecuta al crear el objeto y guarda los datos en self, que es el propio objeto. fit estima y guarda los coeficientes como atributos. forecast los usa. MacroPy funciona igual, con clases más completas. El fragmento siguiente, que no se ejecuta aquí, es el patrón que aparece en el capítulo 4:
from MacroPy import ClassicVARmodel = ClassicVAR(data, lags=4) # data go in oncemodel.Sigma_ols # estimates: attributesmodel.compute_fevd(plot_fevd=False) # analyses: methods
Un valor por defecto mutable, como una lista o un diccionario, se crea una sola vez, cuando se define la función, y se comparte entre todas las llamadas. Si la función lo modifica, la modificación persiste en la llamada siguiente. Por eso los argumentos opcionales que son diccionarios, como los hiperparámetros de un prior, se declaran prior=None y se construyen dentro de la función. Es un error frecuente incluso en bibliotecas publicadas.
0.10 Aleatoriedad y distribuciones
Generadores y semillas. Todo número aleatorio de un computador es pseudoaleatorio: sale de una secuencia determinista que parte de una semilla. Fijar la semilla hace que una simulación sea reproducible, y en un libro eso no es opcional: las bandas del capítulo 4 y las posteriores del capítulo 5 tienen que salir iguales cada vez que se compila. La forma moderna en NumPy es crear un generador propio, rng = np.random.default_rng(semilla), y pedirle las extracciones: rng.standard_normal(n), rng.normal(media, desvío, n), rng.integers(0, T, T), rng.choice(x, n). Cada función de macrobook que simula recibe un argumento seed por esta razón. La interfaz antigua, np.random.seed, fija un estado global compartido por todo el programa y conviene evitarla (Harris et al. 2020).
scipy.stats(Virtanen et al. 2020) reúne las distribuciones con una interfaz común: se construye la distribución con sus parámetros y se le piden la densidad (pdf), la función de distribución (cdf), los cuantiles (ppf), la media o extracciones (rvs).
Normal multivariada. Un vector \(x\) de dimensión \(n\) con media \(\mu\) y covarianza \(\Sigma\) tiene densidad
Es el supuesto sobre los errores de todos los VAR del libro, y la verosimilitud de un VAR es la suma de los logaritmos de esta densidad sobre las observaciones. Se simula con Cholesky, como en la sección 0.5, o con rng.multivariate_normal(mu, Sigma). Toda combinación lineal de una normal multivariada es normal, y sus marginales y condicionales también lo son: esa propiedad es la que hace manejable al filtro de Kalman del capítulo 7.
Gamma e inversa-gamma. La gamma, \(x \sim \text{Gamma}(a, \theta)\) con forma \(a\) y escala \(\theta\), vive en los positivos y tiene media \(a\theta\). Si \(x\) es gamma con forma \(a\) y tasa\(b\) (escala \(1/b\)), su inversa \(1/x\) es inversa-gamma con forma \(a\) y escala \(b\), \(\mathcal{IG}(a, b)\), con media \(b/(a-1)\) para \(a > 1\). La inversa-gamma es el prior conjugado de una varianza en un modelo normal: con un prior \(\mathcal{IG}\) para \(\sigma^2\), la posterior también lo es, y por eso aparece en la estimación bayesiana del AR(1) y en los modelos de espacio de estados y volatilidad de los capítulos 7 a 9.
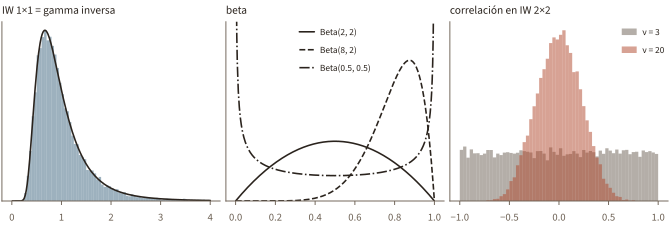
Beta. La beta, \(x \sim \text{Beta}(a, b)\), vive en el intervalo \((0, 1)\), con media \(a/(a+b)\). Es el prior natural para un parámetro acotado, como la persistencia de un componente cíclico o una probabilidad de transición entre regímenes. Una \(\text{Beta}(8, 2)\) tiene media 0.8 y desvío 0.12: dice “persistente, pero no tanto como una raíz unitaria”.
Wishart e inversa-Wishart. Son las distribuciones de matrices de covarianza. Una matriz \(\Sigma\) de \(n \times n\) es inversa-Wishart, \(\Sigma \sim \mathcal{IW}(S, \nu)\), con escala \(S\) y \(\nu\) grados de libertad, si \(\Sigma^{-1}\) es Wishart con escala \(S^{-1}\) y los mismos grados de libertad. Su media es \(S/(\nu - n - 1)\) para \(\nu > n + 1\). Es el prior conjugado de la covarianza de un VAR, el que usa el capítulo 5, y con \(n = 1\) se reduce a la inversa-gamma: \(\mathcal{IW}(s, \nu) = \mathcal{IG}(\nu/2,\ s/2)\). Los grados de libertad controlan cuán informativo es el prior: con \(\nu\) pequeño, casi cualquier correlación entre las variables es plausible.
Distribuciones del libro, su parametrización y su equivalente en scipy.stats
Figura 4: Tres distribuciones del libro. Izquierda: extracciones de una inversa-Wishart de \(1 \times 1\) y la densidad de la inversa-gamma equivalente, que coinciden. Centro: tres betas con parámetros distintos. Derecha: correlación implícita en una inversa-Wishart de \(2 \times 2\) con escala identidad; con pocos grados de libertad casi cualquier correlación es plausible.
Cada libro y cada programa parametriza estas distribuciones a su manera: forma y escala o forma y tasa en la gamma, \(S\) o \(S^{-1}\) en la inversa-Wishart, \(\nu\) o \(\nu/2\) en la inversa-gamma. Un prior escrito en una convención y muestreado en otra da resultados plausibles y equivocados. La defensa es mecánica: antes de usar un muestreador, comparar la media de las extracciones con la fórmula de la tabla, como en la celda de arriba.
El apéndice A de Bayesian Data Analysis(Gelman et al. 2013), gratuito en línea, reúne las densidades, medias y varianzas de todas estas distribuciones con una parametrización única, y el manual de Blake y Mumtaz (2017) muestra cómo aparecen en los muestreadores de los modelos macroeconómicos.
0.11 Simulación: Monte Carlo y bootstrap
Monte Carlo. Si se pueden extraer valores \(x_1, \ldots, x_M\) de una distribución, cualquier esperanza se aproxima por un promedio,
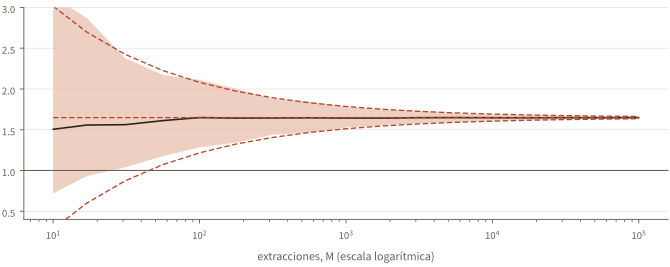
La ley de los grandes números garantiza la convergencia, y el error se achica con \(\sqrt{M}\): para ganar un decimal de precisión hacen falta cien veces más extracciones. Lo mismo vale para cuantiles, probabilidades y cualquier otra característica de la distribución, que es lo que hacen la densidad predictiva y las bandas de todo el libro.
El ejemplo elegido conecta con el capítulo 1. Si \(z \sim N(0, 1)\) es el logaritmo de una variable, la variable es \(e^{z}\), y su media no es \(e^{\mathbb{E}[z]} = 1\) sino \(e^{1/2} \approx 1.649\). Revertir un logaritmo tomando la exponencial de la media devuelve la mediana, no la media.
def mc_means(m, reps, rng, batch=50):"""reps Monte Carlo estimates of E[exp(z)], m draws each.""" out = [np.exp(rng.standard_normal((batch, m))).mean(axis=1)for _ inrange(reps // batch)]return np.concatenate(out)rng = np.random.default_rng(7)sizes = np.unique(np.logspace(1, 5, 17).astype(int))q = np.array([np.quantile(mc_means(m, 400, rng), [0.025, 0.5, 0.975]) for m in sizes])exact = np.exp(0.5)sd_g = np.sqrt(np.exp(2) - np.exp(1)) # sd of exp(z)size = figsize(0.40)fig, ax = plt.subplots(figsize=size)ax.fill_between(sizes, q[:, 0], q[:, 2], lw=0, color=PALETTE["bands"][1], alpha=0.7)ax.plot(sizes, q[:, 1], color=PALETTE["ink"], lw=1.2)for k in (-2, 0, 2): ax.plot(sizes, exact + k * sd_g / np.sqrt(sizes), color=PALETTE["accent"], lw=1.0, ls=(0, (4, 2)))ax.axhline(1.0, color=PALETTE["muted"], lw=0.8)ax.set_xscale("log")ax.set_ylim(0.4, 3.0)ax.set_xlabel("extracciones, M (escala logarítmica)")plt.show()for m in (10, 100, 100_000): row = q[list(sizes).index(m)]print(f"M = {m:>7,}: mediana {row[1]:.3f}, "f"95 % entre {row[0]:.3f} y {row[2]:.3f}")
Figura 5: Distribución de la estimación de Monte Carlo de \(\mathbb{E}[e^{z}]\), con \(z \sim N(0, 1)\), según el número de extracciones \(M\): mediana (línea) y rango entre los percentiles 2.5 y 97.5 (banda) en 400 repeticiones. Las líneas punteadas son el valor exacto, \(e^{1/2}\), y la aproximación normal de más y menos dos errores estándar; la línea gris es \(e^{\mathbb{E}[z]} = 1\).
M =      10: mediana 1.506, 95 % entre 0.719 y 3.131
M =     100: mediana 1.649, 95 % entre 1.284 y 2.111
M = 100,000: mediana 1.649, 95 % entre 1.635 y 1.662
Con diez extracciones la estimación típica queda por debajo del valor exacto y su rango es muy asimétrico, de 0.72 a 3.13: los valores grandes de \(e^{z}\), que son los que suben el promedio, son raros, y con pocas extracciones casi nunca aparecen. Con cien extracciones el rango ya excluye el uno, y con cien mil se reduce a más o menos 0.013 alrededor de \(e^{1/2}\). Lo mismo vale, con más fuerza, para los cuantiles extremos que definen las bandas al 95 %: la varianza de un cuantil estimado crece donde la densidad es baja, de modo que las colas de una posterior piden muchas más extracciones que su media.
Bootstrap. Monte Carlo resuelve el problema cuando se conoce la distribución de la que se extrae. El bootstrap (Efron y Tibshirani 1993) lo resuelve cuando no se conoce: la distribución muestral de un estimador se aproxima reestimándolo sobre muestras artificiales generadas a partir de los propios datos. Con observaciones independientes basta remuestrear con reemplazo. Con series de tiempo eso destruiría la dependencia, así que se remuestrean los residuos y se reconstruye la serie iterando el modelo estimado, que es el algoritmo del capítulo 4 en su versión escalar.
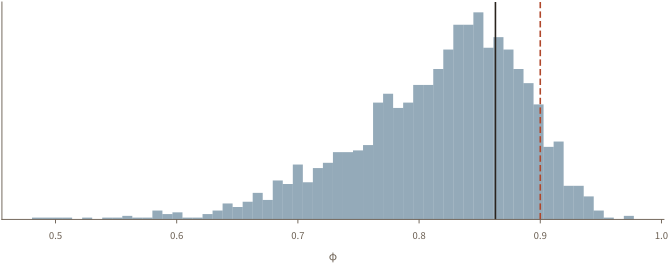
El ejemplo usa una muestra corta y persistente, \(T = 80\) y \(\phi = 0.9\), porque es el caso en que el bootstrap más aporta: el estimador de mínimos cuadrados de \(\phi\) está sesgado hacia abajo en muestras pequeñas, en aproximadamente \(-(1 + 3\phi)/T\)(Kilian 1998), y el bootstrap permite estimar ese sesgo.
def ols_ar1(y):"""OLS of y_t on (1, y_{t-1}): ((c, phi), residuals).""" X = np.column_stack([np.ones(len(y) -1), y[:-1]]) b = np.linalg.solve(X.T @ X, X.T @ y[1:])return b, y[1:] - X @ by_short = simulate_ar1(0.5, 0.9, 1.0, T=80, seed=6)b_hat, e_hat = ols_ar1(y_short)rng = np.random.default_rng(8)phi_star = np.empty(2000)for r inrange(len(phi_star)): e_star = rng.choice(e_hat, size=len(e_hat), replace=True) y_star = np.empty_like(y_short) y_star[0] = y_short[0]for t inrange(1, len(y_short)): # iterate the model y_star[t] = (b_hat[0] + b_hat[1] * y_star[t -1]+ e_star[t -1]) phi_star[r] = ols_ar1(y_star)[0][1]bias = phi_star.mean() - b_hat[1]lo, hi = np.quantile(phi_star, [0.025, 0.975])print(f"phi estimado: {b_hat[1]:.3f}")print(f"sesgo bootstrap: {bias:+.3f}")print(f"phi corregido: {b_hat[1] - bias:.3f}")print(f"intervalo al 95 %: [{lo:.3f}, {hi:.3f}]")
# The true bias, by Monte Carlo: possible only because here# the data-generating process is known.phi_mc = np.array([ols_ar1(simulate_ar1(0.5, 0.9, 1.0, 80, seed=100+ i))[0][1]for i inrange(3000)])true_bias = phi_mc.mean() -0.9approx =-(1+3*0.9) /80print(f"sesgo verdadero (Monte Carlo): {true_bias:+.3f}")print(f"aproximación -(1+3 phi)/T: {approx:+.3f}")
Figura 6: Distribución bootstrap de \(\hat{\phi}\) en un AR(1) con \(T = 80\). La línea continua es la estimación sobre la muestra y la punteada, el valor verdadero con que se simuló. La distribución está desplazada hacia la izquierda de la estimación: ese desplazamiento es la estimación bootstrap del sesgo.
El bootstrap estima un sesgo de \(-0.047\) y el verdadero, calculado por Monte Carlo con 3000 muestras del proceso conocido, es de \(-0.055\). La aproximación analítica da \(-0.046\). Corregir la estimación por el sesgo bootstrap la acerca al valor verdadero, y esa es la idea del bootstrap con corrección de sesgo de Kilian (1998), el estándar para las bandas de los VAR estructurales.
El bootstrap tiene que reproducir la estructura de dependencia de los datos. Remuestrear observaciones de una serie de tiempo, o sumar residuos remuestreados a los valores ajustados sin iterar el modelo, produce muestras artificiales con otra dinámica y bandas que no significan nada. Cerca de una raíz unitaria el bootstrap también falla, porque la distribución del estimador cambia de forma de manera discontinua justo en \(\phi = 1\).
0.12 Otros temas
Optimización y máxima verosimilitud
Cuando la posterior no se puede muestrear o el modelo se estima por máxima verosimilitud, como los de espacio de estados del capítulo 7, hace falta optimizar. scipy.optimize.minimize minimiza cualquier función de un vector de parámetros; se le pasa el negativo de la log-verosimilitud y un valor inicial. Tres prácticas evitan la mayoría de los problemas: reparametrizar para que los parámetros no tengan restricciones (el logaritmo de una varianza, en lugar de la varianza), partir de valores iniciales razonables y probar varios puntos de partida.
Álgebra numérica
Las fórmulas del libro están escritas con inversas porque así se leen mejor, pero el código no siempre debe calcularlas: solve y la factorización de Cholesky son más estables. Una matriz que en teoría es simétrica sale del computador con asimetrías del orden de \(10^{-16}\), suficientes para que algunas funciones la rechacen; por eso el muestreador del capítulo 5 simetriza la covarianza con (V + V.T) / 2 antes de extraer. Y np.linalg.cholesky es la forma más barata de verificar que una matriz es definida positiva: falla si no lo es.
Rendimiento
La primera regla es vectorizar. La segunda, medir antes de optimizar: casi siempre el tiempo se va en un solo bucle. Cuando ese bucle no se puede vectorizar, como en una recursión o en un muestreador, Numba lo compila con un decorador y sin reescribir el código.
Control de versiones y reproducibilidad
Un proyecto empírico reproducible tiene tres piezas: el código bajo control de versiones con git, un entorno fijado (en este libro, pyproject.toml y uv.lock) y los datos crudos separados de los construidos, con un script que va de unos a otros. La guía de Gentzkow y Shapiro (2014) sigue siendo la mejor introducción breve a por qué importa y cómo se organiza.
Ideas clave
El AR(1) es un VAR de una variable: quien lo simula, lo estima, estudia su estabilidad y lo remuestrea con las herramientas de este capítulo ya tiene las piezas de los VAR.
En NumPy, @ es el producto matricial y * el producto elemento a elemento; los sistemas se resuelven con solve, y \(\operatorname{vec}\) se escribe con order="F".
Los autovalores deciden la estabilidad y la forma de las respuestas: módulo menor que uno para que decaigan, parte imaginaria para que oscilen.
La factorización de Cholesky simula normales correlacionadas y es la identificación recursiva; que \(LQ\) sirva igual que \(L\) es el problema de identificación.
Monte Carlo aproxima esperanzas con promedios, y el bootstrap aproxima distribuciones muestrales reestimando sobre muestras que respetan la dinámica.
todos los resultados de álgebra matricial que usan los VAR, con \(\operatorname{vec}\) y Kronecker incluidos.
Gelman et al. (2013)
Bayesian Data Analysis, gratuito en línea; su apéndice A es el catálogo de distribuciones de referencia.
Efron y Tibshirani (1993)
la introducción clásica al bootstrap, escrita por su inventor.
Ejercicios
Modifique simulate_ar1 para que acepte un valor inicial arbitrario y simule 1000 trayectorias de 200 periodos con \(\phi = 1\) y \(c = 0\). Verifique que la varianza entre trayectorias crece linealmente con \(t\), como corresponde a una caminata aleatoria, y compárela con el caso \(\phi = 0.8\).
Ver solución
Con \(\phi = 1\), \(y_t = y_0 + \sum_{s=1}^{t} \varepsilon_s\), de modo que \(\operatorname{Var}(y_t) = t\sigma^2\): la varianza entre trayectorias en el periodo \(t\) debe estar cerca de \(t\). Con \(\phi = 0.8\) la varianza es \((1 - 0.64^{t})/(1 - 0.64)\), que llega al 99 % de su límite, 2.78, en diez periodos y deja de crecer. Basta apilar las trayectorias en una matriz de \(1000 \times 200\) y calcular paths.var(axis=0).
Para la matriz con autovalores complejos de la sección 0.4, obtenga con np.linalg.eig los autovalores y autovectores, verifique que \(A^{10} = V\Lambda^{10}V^{-1}\) y calcule el periodo de la oscilación.
Ver solución
lam, V = np.linalg.eig(A)A10 = V @ np.diag(lam**10) @ np.linalg.inv(V)np.allclose(A10.real, np.linalg.matrix_power(A, 10))
La reconstrucción coincide con la potencia directa; la parte imaginaria de A10 es del orden de \(10^{-17}\), puro error de redondeo, y se descarta con .real. El ángulo de los autovalores, np.angle(lam[0]), es de 0.39 radianes, de modo que el periodo es \(2\pi/0.39 \approx 16\) periodos.
Escriba la función inversa de vec, que reciba un vector y el número de filas y devuelva la matriz. Úsela para verificar que \(\operatorname{vec}(XB) = (I_n \otimes X)\operatorname{vec}(B)\) con \(X\) de \(50 \times 5\) y \(B\) de \(5 \times 3\).
Ver solución
def unvec(v, rows): return v.reshape((rows, -1), order="F"). La verificación es np.allclose(vec(X @ B), np.kron(np.eye(3), X) @ vec(B)). Si se olvida order="F" en cualquiera de los dos lados, la comparación falla aunque las formas coincidan.
Con el IPC de Estados Unidos, calcule la inflación trimestral anualizada a partir de los promedios trimestrales del índice, \(400\,\Delta \ln \bar{P}_q\), y compárela gráficamente con la inflación interanual del último mes de cada trimestre. ¿Cuál reacciona antes a los cambios de tendencia de 2021 y 2023?
Ver solución
cpi_q = cpi.resample("Q").mean() y 400 * np.log(cpi_q).diff(). La tasa trimestral anualizada sube y baja antes que la interanual, porque compara contra el trimestre anterior y no promedia los últimos doce meses; a cambio, es más ruidosa y conserva algo de estacionalidad, que habría que remover con los métodos del capítulo 1.
Estime por Monte Carlo el sesgo del estimador de mínimos cuadrados de \(\phi\) con \(\phi = 0.9\) y \(T \in \{50, 100, 200, 400\}\), y compárelo con la aproximación \(-(1+3\phi)/T\). ¿Qué implica el resultado para los VAR trimestrales estimados con veinte años de datos?
Ver solución
El sesgo se reduce aproximadamente a la mitad cada vez que \(T\) se duplica, y la aproximación es buena salvo en la muestra más corta. Veinte años de datos trimestrales son 80 observaciones: el sesgo en la persistencia es del orden de cinco centésimas, suficiente para que las respuestas al impulso estimadas decaigan más rápido que las verdaderas. Es una de las razones para el bootstrap con corrección de sesgo y para el prior de Minnesota, que empuja la persistencia hacia arriba.
Blake, Andrew P., y Haroon Mumtaz. 2017. Applied Bayesian Econometrics for Central Bankers. Technical Handbook. Centre for Central Banking Studies, Bank of England.
Efron, Bradley, y Robert J. Tibshirani. 1993. An Introduction to the Bootstrap. Chapman; Hall.
Gelman, Andrew, John B. Carlin, Hal S. Stern, David B. Dunson, Aki Vehtari, y Donald B. Rubin. 2013. Bayesian Data Analysis. 3.ª ed. Chapman; Hall/CRC. https://sites.stat.columbia.edu/gelman/book/.
Sargent, Thomas J., y John Stachurski. s. f.-a. «Intermediate Quantitative Economics with Python». QuantEcon. Accedido 21 de septiembre de 2026. https://python.quantecon.org/intro.html.
Virtanen, Pauli, Ralf Gommers, Travis E. Oliphant, et al. 2020. «SciPy 1.0: fundamental algorithms for scientific computing in Python». Nature Methods 17 (3): 261-72.