3 Vectores autorregresivos
¿Cómo se mueven juntas varias series macroeconómicas cuando no queremos comprometernos con una teoría completa de la economía?
- Escribir el mismo VAR de tres maneras (ecuación por ecuación, compacta y companion) y saber para qué sirve cada una.
- Estimarlo por mínimos cuadrados, verificar su estabilidad y pronosticar con la forma companion.
- Entender por qué los residuos de la forma reducida no son choques económicos.
Requisitos previos. Capítulo 2; álgebra matricial (inversa, valores propios, matrices particionadas); distribución normal multivariada.
| Serie | Fuente | Frecuencia | Transformación |
|---|---|---|---|
| Inflación (\(\pi_t\)) | BCRP | trimestral | var. % interanual del IPC |
| Tasa de referencia (\(r_t\)) | BCRP | trimestral | nivel, % anual |
El archivo crudo es data/raw/database_peru.xlsx (hoja domestic) y el CSV que leen los capítulos lo construye code/python/build_peru_data.py. El VAR se estima entre 2003Q4 y 2017Q4, y los ocho trimestres siguientes (2018-2019) quedan fuera de la muestra para evaluar el pronóstico.
3.1 Qué hace un VAR
En su revisión de 2001, Stock y Watson describen el trabajo del macroeconometrista en cuatro tareas: describir y resumir series macroeconómicas, pronosticar, recuperar la estructura de la economía a partir de los datos y asesorar a quien decide la política. El VAR es la herramienta estadística que sostiene las cuatro.
Tomemos dos variables, la inflación (\(\pi_t\)) y la tasa de interés de política (\(r_t\)). Un VAR ayuda a responder:
- ¿Cómo es el comportamiento dinámico de estas variables y cómo interactúan entre sí?
- ¿Qué inflación es consistente con la trayectoria de tasas de los próximos trimestres?
- ¿Cuál es el efecto de un choque de política monetaria sobre la inflación?
- ¿Cuánto aportaron históricamente los choques de política a las fluctuaciones de la inflación?
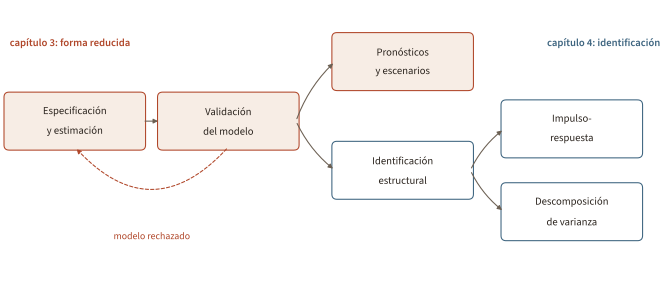
Las dos primeras se responden con el modelo de forma reducida de este capítulo. Las dos últimas exigen una hipótesis de identificación y son el asunto del Capítulo 4. La Figura 3.1 ordena el recorrido.
Un VAR es una regresión de cada variable sobre el pasado de todas. No hay teoría dentro: la teoría entra al elegir qué variables incluir, en qué transformación, con cuántos rezagos y, sobre todo, al identificar los choques.
3.2 El VAR(p) ecuación por ecuación
Definición 3.1 · VAR(p) de forma reducida Sea \(\mathbf{y}_t\) un vector \(n \times 1\) de variables observadas. El VAR de orden \(p\) es
\[ \mathbf{y}_t = c + \Phi_1 \mathbf{y}_{t-1} + \Phi_2 \mathbf{y}_{t-2} + \cdots + \Phi_p \mathbf{y}_{t-p} + \mathbf{u}_t, \qquad \mathbf{u}_t \sim N(0, \Sigma), \tag{3.1}\]
donde \(c\) es \(n \times 1\), cada \(\Phi_\ell\) es \(n \times n\), \(\mathbb{E}[\mathbf{u}_t] = 0\) y \(\mathbb{E}[\mathbf{u}_t \mathbf{u}_s'] = 0\) para \(t \neq s\).
Con dos variables y dos rezagos, la Ecuación 3.1 es un sistema de dos ecuaciones:
\[ \begin{bmatrix} \pi_t \\ r_t \end{bmatrix} = \begin{bmatrix} c_1 \\ c_2 \end{bmatrix} + \begin{bmatrix} \phi^1_{11} & \phi^1_{12} \\ \phi^1_{21} & \phi^1_{22} \end{bmatrix} \begin{bmatrix} \pi_{t-1} \\ r_{t-1} \end{bmatrix} + \begin{bmatrix} \phi^2_{11} & \phi^2_{12} \\ \phi^2_{21} & \phi^2_{22} \end{bmatrix} \begin{bmatrix} \pi_{t-2} \\ r_{t-2} \end{bmatrix} + \begin{bmatrix} u_{1t} \\ u_{2t} \end{bmatrix}. \tag{3.2}\]
Dos detalles que conviene fijar desde el inicio. Primero, \(\mathbf{u}_t\) no tiene autocorrelación pero sí correlación contemporánea: \(\Sigma\) no es diagonal, y por eso no se puede mover \(u_{2t}\) dejando fijo \(u_{1t}\). A eso vuelve la Sección 3.8. Segundo, todas las ecuaciones tienen exactamente los mismos regresores, y de ahí saldrá el resultado de estimación de la Sección 3.7.
El conteo de parámetros crece con el cuadrado del número de variables. Cada ecuación tiene \(k = np + 1\) coeficientes y el sistema tiene \(nk\):
| Variables (\(n\)) | Rezagos (\(p\)) | Coeficientes por ecuación | Total |
|---|---|---|---|
| 2 | 2 | 5 | 10 |
| 3 | 4 | 13 | 39 |
| 5 | 4 | 21 | 105 |
| 7 | 4 | 29 | 203 |
La muestra trimestral de este capítulo tiene 57 observaciones para los diez coeficientes del caso más pequeño de la Tabla 3.1. Con cinco variables y cuatro rezagos harían falta 105, más de los datos disponibles en casi cualquier economía. Por eso existe el Capítulo 5.
3.3 La forma compacta
Para estimar conviene apilar las \(T\) observaciones. Con \(p = 2\) y las dos variables de la Ecuación 3.2:
\[ \underbrace{\begin{bmatrix} \pi_1 & r_1 \\ \pi_2 & r_2 \\ \vdots & \vdots \\ \pi_T & r_T \end{bmatrix}}_{Y\ (T \times n)} = \underbrace{\begin{bmatrix} 1 & \pi_0 & r_0 & \pi_{-1} & r_{-1} \\ 1 & \pi_1 & r_1 & \pi_0 & r_0 \\ \vdots & \vdots & \vdots & \vdots & \vdots \\ 1 & \pi_{T-1} & r_{T-1} & \pi_{T-2} & r_{T-2} \end{bmatrix}}_{X\ (T \times k)} \underbrace{\begin{bmatrix} c_1 & c_2 \\ \phi^1_{11} & \phi^1_{21} \\ \phi^1_{12} & \phi^1_{22} \\ \phi^2_{11} & \phi^2_{21} \\ \phi^2_{12} & \phi^2_{22} \end{bmatrix}}_{B\ (k \times n)} + \underbrace{\begin{bmatrix} u_{11} & u_{21} \\ u_{12} & u_{22} \\ \vdots & \vdots \\ u_{1T} & u_{2T} \end{bmatrix}}_{U\ (T \times n)}, \tag{3.3}\]
es decir
\[ Y = XB + U. \tag{3.4}\]
La columna \(j\) de \(B\) contiene los coeficientes de la ecuación \(j\), la primera fila es el intercepto y la matriz \(X\) es la misma para todas.
El lugar de la constante es una convención, no un resultado. En el libro va primero, como en las pizarras y en Blake y Mumtaz; MacroPy la pone al final, después de todos los rezagos. Si se mezclan las dos convenciones, el prior del Capítulo 5 termina encogiendo el intercepto en lugar del primer rezago. Conviene imprimir una fila de \(B\) y verificar el orden antes de seguir.
3.4 Los datos: inflación y tasa de referencia
El resto del capítulo trabaja con dos series trimestrales del Perú: la inflación interanual y la tasa de referencia del BCRP. La muestra de estimación va de 2003Q4 a 2017Q4, y los dos años siguientes se reservan para evaluar el pronóstico.
Las dos fechas de corte son decisiones sustantivas, no detalles técnicos. El inicio viene impuesto por los datos: el BCRP adopta las metas explícitas de inflación en 2002 y publica la tasa de referencia recién desde septiembre de 2003, de modo que antes de esa fecha no hay un instrumento de política observado que poner en el sistema. El final deja fuera la pandemia y el episodio inflacionario posterior, dos movimientos de una magnitud que un VAR lineal con innovaciones gaussianas no describe bien: incluirlos haría que unos pocos trimestres determinaran los coeficientes. El costo de ambos recortes es una muestra de 57 observaciones para 10 parámetros, que es exactamente la tensión que motiva el Capítulo 5.
import numpy as np
import pandas as pd

from macrobook import data_path, var

csv = data_path("peru_domestic.csv")
data = pd.read_csv(csv, index_col="date")
data.index = pd.PeriodIndex(data.index, freq="Q")

series = ["inf", "mpr"]
sample = data.loc["2003Q4":"2017Q4", series]   # estimación
future = data.loc["2018Q1":"2019Q4", series]   # evaluación
dates = sample.index.to_timestamp(how="end")
y = sample.to_numpy()
n, p = y.shape[1], 2

span = f"{sample.index[0]} a {sample.index[-1]}"
print(f"muestra: {span}, {len(sample)} observaciones")
sample.describe().round(2).T
muestra: 2003Q4 a 2017Q4, 57 observaciones| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| inf | 57.0 | 3.01 | 1.34 | 0.41 | 2.17 | 3.01 | 3.60 | 6.65 |
| mpr | 57.0 | 3.83 | 1.12 | 1.15 | 3.13 | 4.16 | 4.37 | 6.56 |
import matplotlib.pyplot as plt

from macrobook import use_style, figsize, PALETTE, charts

use_style()

size = figsize(0.58)
fig, axes = plt.subplots(2, 1, sharex=True, figsize=size)
labels = ["inflación (%)", "tasa de referencia (%)"]
for ax, column, label in zip(axes, sample.columns, labels):
    ax.plot(dates, sample[column], color=PALETTE["ink"], lw=1.0)
    ax.set_ylabel(label)
charts.zero_line(axes[0])
axes[1].set_xlabel("")
plt.show()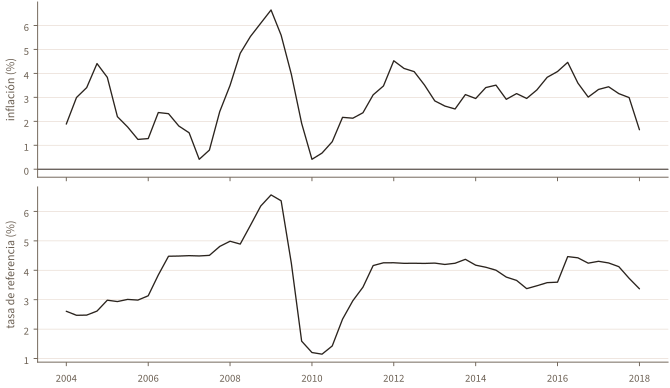
Las dos series se mueven juntas y con persistencia: los episodios de inflación alta (2008, 2011) vienen acompañados de subidas de la tasa, con rezago. Ese comovimiento es lo que el VAR va a describir, y también la razón por la que describirlo no basta para hablar de efectos de política.
3.5 La forma companion
Todo VAR(p) es un VAR(1) de mayor dimensión. Con el sistema de la Ecuación 3.2, basta apilar el vector de hoy con el de ayer:
\[ \underbrace{\begin{bmatrix} \pi_t \\ r_t \\ \pi_{t-1} \\ r_{t-1} \end{bmatrix}}_{\tilde{\mathbf{y}}_t} = \underbrace{\begin{bmatrix} c_1 \\ c_2 \\ 0 \\ 0 \end{bmatrix}}_{\tilde{c}} + \underbrace{\begin{bmatrix} \phi^1_{11} & \phi^1_{12} & \phi^2_{11} & \phi^2_{12} \\ \phi^1_{21} & \phi^1_{22} & \phi^2_{21} & \phi^2_{22} \\ 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \end{bmatrix}}_{F\ (4 \times 4)} \begin{bmatrix} \pi_{t-1} \\ r_{t-1} \\ \pi_{t-2} \\ r_{t-2} \end{bmatrix} + \underbrace{\begin{bmatrix} u_{1t} \\ u_{2t} \\ 0 \\ 0 \end{bmatrix}}_{\tilde{\mathbf{u}}_t}. \tag{3.5}\]
Las dos últimas filas son identidades contables: dicen que \(\pi_{t-1}\) de hoy es \(\pi_t\) de ayer. En general, con \(\tilde{\mathbf{y}}_t = (\mathbf{y}_t', \mathbf{y}_{t-1}', \ldots, \mathbf{y}_{t-p+1}')'\) de dimensión \(np\),
\[ \tilde{\mathbf{y}}_t = \tilde{c} + F \tilde{\mathbf{y}}_{t-1} + \tilde{\mathbf{u}}_t, \qquad F = \begin{bmatrix} \Phi_1 & \Phi_2 & \cdots & \Phi_{p-1} & \Phi_p \\ I_n & 0 & \cdots & 0 & 0 \\ 0 & I_n & \cdots & 0 & 0 \\ \vdots & & \ddots & & \vdots \\ 0 & 0 & \cdots & I_n & 0 \end{bmatrix}, \tag{3.6}\]
y con el selector \(J = [\,I_n \; 0 \; \cdots \; 0\,]\) se recupera el vector original, \(\mathbf{y}_t = J \tilde{\mathbf{y}}_t\).
La forma companion cambia \(p\) matrices por una sola. Todo lo que quiera decirse sobre el futuro del sistema, o sobre su estabilidad, se vuelve una afirmación sobre potencias de \(F\).
El código imprime, junto con \(F\), el módulo del mayor de sus valores propios. Ese número decide si el sistema es estable, que es el asunto de la sección siguiente.
def companion(B, n, p):
    """Build F from B (k x n, constant in the first row)."""
    F = np.zeros((n * p, n * p))
    for lag in range(p):
        rows = slice(1 + lag * n, 1 + (lag + 1) * n)
        F[:n, lag * n : (lag + 1) * n] = B[rows, :].T
    if p > 1:
        F[n:, : n * (p - 1)] = np.eye(n * (p - 1))
    return F

fit = var.ols(y, p)
F = companion(fit["B"], n, p)
eigenvalues = np.linalg.eigvals(F)

print("máximo módulo:", np.abs(eigenvalues).max().round(3))
np.round(F, 3)
máximo módulo: 0.838array([[ 1.297, 0.16 , -0.6 , -0.081],
[ 0.145, 1.326, -0.217, -0.493],
[ 1. , 0. , 0. , 0. ],
[ 0. , 1. , 0. , 0. ]])F_package = var.companion(fit["B"], n, p)
np.allclose(F, F_package)True3.6 Estabilidad y estacionariedad
Definición 3.2 · Estacionariedad en covarianza El proceso \(\{\mathbf{y}_t\}_{t \in \mathbb{Z}}\) es estacionario en covarianza, o débilmente estacionario, si sus dos primeros momentos existen y no dependen de la fecha:
- Media constante: \(\mathbb{E}[\mathbf{y}_t] = \mu\) para todo \(t\).
- Autocovarianzas que sólo dependen del rezago: \(\mathbb{E}\big[(\mathbf{y}_t - \mu)(\mathbf{y}_{t-j} - \mu)'\big] = \Gamma_j\) para todo \(t\) y todo \(j \geq 0\), con \(\Gamma_0\) finita.
La Definición 3.2 es una propiedad del proceso, no de la muestra: ninguna prueba la verifica directamente. La condición que la garantiza en un VAR es una propiedad de \(F\).
Proposición 3.1 · Estabilidad El VAR de la Ecuación 3.1 es estable si y sólo si todos los valores propios de la matriz companion \(F\) tienen módulo menor que uno,
\[ \max_i |\lambda_i(F)| < 1 \iff \det\big(I_n - \Phi_1 z - \cdots - \Phi_p z^p\big) \neq 0 \ \text{ para } |z| \leq 1 . \]
Si el VAR es estable, admite la representación de Wold
\[ \mathbf{y}_t = \mu + \sum_{j=0}^{\infty} \Psi_j \mathbf{u}_{t-j}, \qquad \Psi_j = J F^j J', \tag{3.7}\]
con media incondicional \(\mu = (I_n - \Phi_1 - \cdots - \Phi_p)^{-1} c\), y es estacionario en covarianza.
La idea detrás de la Ecuación 3.7 es una sustitución recursiva. Partiendo de \(\mathbf{y}_t = \Phi_1 \mathbf{y}_{t-1} + \mathbf{u}_t\) y reemplazando el rezago una y otra vez,
\[ \mathbf{y}_t = \Phi_1(\Phi_1 \mathbf{y}_{t-2} + \mathbf{u}_{t-1}) + \mathbf{u}_t = \cdots = \Phi_1^{t}\mathbf{y}_0 + \sum_{j=0}^{t-1} \Phi_1^{j} \mathbf{u}_{t-j}, \]
de modo que cada observación es una combinación de los choques presentes y pasados más una condición inicial. Si \(\Phi_1^{j}\) no converge a cero, la condición inicial nunca se olvida y la varianza crece sin límite.
roots = var.roots(fit["B"], n, p)

ratios = {"width_ratios": [1, 1.4]}
fig, (ax_plane, ax_mod) = plt.subplots(
    1, 2, figsize=figsize(0.36), gridspec_kw=ratios)
charts.unit_circle(ax_plane, roots)

modulus = np.abs(roots)
position = np.arange(len(modulus))[::-1]
ax_mod.hlines(position, 0, modulus,
              color=PALETTE["rule"], lw=1.0)
ax_mod.plot(modulus, position, ls="none", marker="o", ms=4,
            color=PALETTE["accent"])
ax_mod.axvline(1.0, color=PALETTE["ink"], lw=0.8,
               ls=(0, (4, 2)))
n_roots = len(modulus)
tick_labels = [f"$\\lambda_{{{i+1}}}$" for i in range(n_roots)]
ax_mod.set_yticks(position, tick_labels)
ax_mod.set_xlim(0, 1.15)
ax_mod.set_xlabel("módulo")
ax_mod.grid(False, axis="y")
plt.show()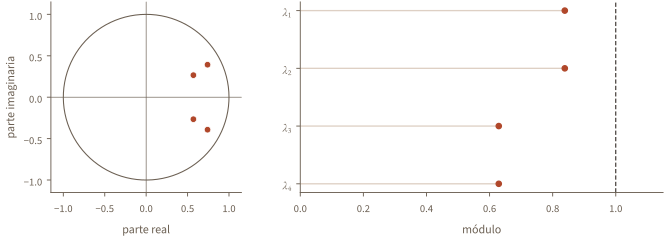
La estabilidad tiene consecuencias visibles: sin choques, el sistema regresa a su media incondicional desde cualquier punto de partida.
mu = var.unconditional_mean(fit["B"], n, p)
phis, c_hat = var.coefficients_by_lag(fit["B"], n, p)

def path_without_shocks(start, steps=24):
    history = [np.asarray(start, float)] * p
    out = []
    for _ in range(steps):
        terms = (Phi @ history[lag]
                 for lag, Phi in enumerate(phis))
        nxt = c_hat + sum(terms)
        out.append(nxt)
        history = [nxt] + history[:-1]
    return np.array(out)

fig, ax = plt.subplots(figsize=figsize(0.52))
for k, start in enumerate([[0.0, 2.0], [7.0, 3.0], [3.0, 7.0]]):
    path = path_without_shocks(start)
    ax.plot(path[:, 0], color=PALETTE["shocks"][k], lw=1.1,
            ls=PALETTE["shock_linestyle"][k],
            label=f"$\\pi_0 = {start[0]:.0f}$, "
                  f"$r_0 = {start[1]:.0f}$")
ax.axhline(mu[0], color=PALETTE["accent"], lw=1.0,
           ls=(0, (1, 2)))
ax.set_ylabel("inflación (%)")
ax.set_xlabel("trimestres")
charts.legend_outside(ax, ncol=3)
plt.show()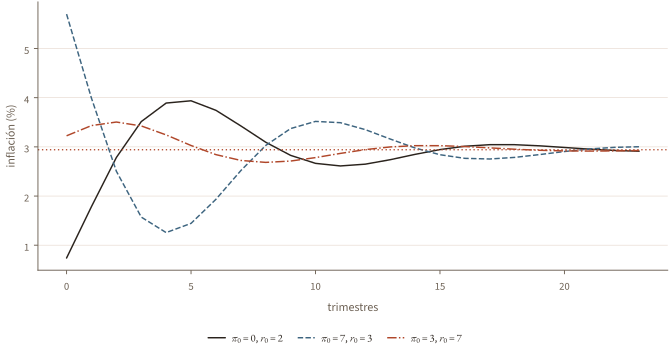
La estabilidad hace falta para que existan los momentos incondicionales, para que las respuestas al impulso converjan a cero y para que la descomposición de varianza tenga sentido. No hace falta para estimar: mínimos cuadrados está bien definido aunque haya una raíz unitaria, y el pronóstico a horizonte finito también. La práctica estándar no es diferenciar por reflejo (Sims et al. 1990): qué variable entra al sistema y en qué transformación se decide antes de estimar, y la Sección 3.10 discute con qué criterio.
3.7 Estimación por mínimos cuadrados
Proposición 3.2 · Mínimos cuadrados ecuación por ecuación En el VAR sin restricciones, donde todas las ecuaciones comparten los regresores \(X\), el estimador de mínimos cuadrados ecuación por ecuación
\[ \hat{B} = (X'X)^{-1}X'Y, \qquad \hat{\Sigma} = \frac{(Y - X\hat{B})'(Y - X\hat{B})}{T - k} \tag{3.8}\]
coincide con el estimador de mínimos cuadrados generalizados del sistema completo y, bajo normalidad, con el estimador de máxima verosimilitud condicionado a las \(p\) observaciones iniciales.
El resultado, que se demuestra en el Ejercicio 5.1 con el sistema escrito como una sola regresión, es el que permite tratar \(n\) ecuaciones como \(n\) regresiones separadas. Su contracara aparece en el Capítulo 5: en cuanto el prior enlaza las ecuaciones, o \(\Sigma\) entra en la restricción, la separabilidad se pierde.
def lag_matrix(y, p):
    """Y = y[p:] and X = [1, y_{t-1}, ..., y_{t-p}]."""
    T, n = y.shape
    columns = [y[p - lag : T - lag] for lag in range(1, p + 1)]
    X = np.column_stack([np.ones(T - p)] + columns)
    return y[p:], X

Y, X = lag_matrix(y, p)
B_ols = np.linalg.solve(X.T @ X, X.T @ Y)
U = Y - X @ B_ols
T_eff, k = X.shape
Sigma_ols = U.T @ U / (T_eff - k)

# Standard errors: equation i uses Sigma_ii * (X'X)^{-1}.
XtX_inv = np.linalg.inv(X.T @ X)
se = np.sqrt(np.outer(np.diag(XtX_inv), np.diag(Sigma_ols)))

rows = ["constante", "π(-1)", "r(-1)", "π(-2)", "r(-2)"]
cols = sample.columns
coef = pd.DataFrame(B_ols, index=rows, columns=cols).round(3)
stderr = pd.DataFrame(se, index=rows, columns=cols).round(3)
report = coef.astype(str) + " (" + stderr.astype(str) + ")"
report.columns = ["ecuación de π", "ecuación de r"]
report| ecuación de π | ecuación de r | |
|---|---|---|
| constante | 0.583 (0.3) | 0.867 (0.193) |
| π(-1) | 1.297 (0.139) | 0.145 (0.09) |
| r(-1) | 0.16 (0.19) | 1.326 (0.123) |
| π(-2) | -0.6 (0.139) | -0.217 (0.09) |
| r(-2) | -0.081 (0.19) | -0.493 (0.122) |
fit = var.ols(y, p)
(np.allclose(fit["B"], B_ols),
 np.allclose(fit["Sigma"], Sigma_ols))
(True, True)Entre paréntesis van los errores estándar de mínimos cuadrados, \(\sqrt{\hat{\sigma}_{ii}\,[(X'X)^{-1}]_{jj}}\) para el coeficiente \(j\) de la ecuación \(i\). La lectura inmediata es que cada serie depende sobre todo de su propio pasado. En la ecuación de la inflación los coeficientes de la tasa son pequeños frente a su error estándar; en la ecuación de la tasa los de la inflación son mayores, pero con signos opuestos entre el primer y el segundo rezago. Leer coeficientes de a uno en un VAR rara vez informa: conviene mirar sumas que resuman el sistema.
phis, c_hat = var.coefficients_by_lag(np.asarray(B_ols), n, p)
persistence = [sum(Phi[i, i] for Phi in phis) for i in range(n)]
rate_on_inflation = sum(Phi[0, 1] for Phi in phis)  # r -> π
inflation_on_rate = sum(Phi[1, 0] for Phi in phis)  # π -> r

print(f"persistencia propia de π: {persistence[0]:.2f}")
print(f"persistencia propia de r: {persistence[1]:.2f}")
print(f"suma de r en ecuación de π: {rate_on_inflation:+.2f}")
print(f"suma de π en ecuación de r: {inflation_on_rate:+.2f}")
persistencia propia de π: 0.70
persistencia propia de r: 0.83
suma de r en ecuación de π: +0.08
suma de π en ecuación de r: -0.07Cada cifra es la suma de los dos coeficientes correspondientes de la tabla anterior: la persistencia de la inflación es \(1.297 - 0.600\), y la suma de los coeficientes de la tasa en esa misma ecuación es \(0.160 - 0.081\). Las dos series son persistentes y las sumas cruzadas son casi cero, con la de la tasa sobre la inflación incluso ligeramente positiva. Sería un error leer esa cifra como “subir la tasa no baja la inflación, o la sube”: lo que mide es la correlación parcial entre la tasa de ayer y la inflación de hoy en una muestra donde el banco central subía la tasa precisamente cuando esperaba más inflación. La Sección 3.8 desarrolla ese punto.
3.8 La matriz de covarianzas y el problema de los choques
Hasta aquí \(\Sigma\) ha sido un objeto secundario. Es, en realidad, donde se esconde todo lo que la forma reducida no puede responder. Por definición,
\[ \Sigma = \mathbb{E}[\mathbf{u}_t \mathbf{u}_t'] = \begin{bmatrix} \mathbb{E}[u_{1t}^2] & \mathbb{E}[u_{1t} u_{2t}] \\ \mathbb{E}[u_{2t} u_{1t}] & \mathbb{E}[u_{2t}^2] \end{bmatrix} = \begin{bmatrix} \sigma_1^2 & \sigma_{12} \\ \sigma_{12} & \sigma_2^2 \end{bmatrix}, \tag{3.9}\]
una matriz simétrica con \(n(n+1)/2\) elementos distintos: tres en el caso bivariado. El elemento que importa es el de fuera de la diagonal.
Sigma_hat = fit["Sigma"]
sd = np.sqrt(np.diag(Sigma_hat))
rho = Sigma_hat[0, 1] / (sd[0] * sd[1])
beta = Sigma_hat[0, 1] / Sigma_hat[1, 1]      # E[u_1 | u_2 = 1]

print("Sigma estimada:\n", np.round(Sigma_hat, 3))
print(f"desviaciones estándar: π {sd[0]:.2f}, r {sd[1]:.2f}")
print(f"correlación entre innovaciones: {rho:.2f}")
print(f"E[u_π | u_r = 1] = {beta:.2f}")
Sigma estimada:
[[0.363 0.101]
[0.101 0.151]]
desviaciones estándar: π 0.60, r 0.39
correlación entre innovaciones: 0.43
E[u_π | u_r = 1] = 0.67Los residuos de la forma reducida son errores de pronóstico, no choques económicos: \(u_{1t}\) es la parte de la inflación de hoy que el pasado del sistema no anticipaba, y lo mismo \(u_{2t}\) para la tasa. Nada garantiza que esas sorpresas tengan una interpretación económica, y de hecho están correlacionadas entre sí.
Con \(\rho \neq 0\), la pregunta “¿qué pasa con la inflación si la tasa sube una unidad de manera inesperada, manteniendo todo lo demás constante?” no tiene respuesta dentro de este modelo. En los datos, las veces en que \(u_{2t} = 1\) vienen acompañadas en promedio por \(u_{1t} = \sigma_{12}/\sigma_2^2 \neq 0\): mover una innovación dejando la otra fija describe una combinación de sorpresas que la muestra no contiene. Una supuesta impulso-respuesta calculada sobre \(\mathbf{u}_t\) no es causal; es una correlación dinámica disfrazada.
Vale la pena leer lo mismo a nivel de coeficientes. En la ecuación de la inflación, la suma de los coeficientes de la tasa resultó prácticamente nula, y en la ecuación de la tasa la suma de los coeficientes de la inflación también. Ninguna de las dos cifras mide un efecto causal, porque ambas describen una muestra en la que el banco central movía la tasa en respuesta a lo que veía venir en los precios. Si la política fue sistemática y razonablemente exitosa, la tasa sube justo antes de los episodios inflacionarios y baja cuando ceden: la correlación parcial resultante puede tener cualquier signo, y de hecho la literatura empírica encontró durante años coeficientes con el signo “equivocado”, el llamado price puzzle, precisamente por esta razón.
La salida es suponer que las sorpresas observadas son combinaciones lineales de choques no observados con significado económico,
\[ \mathbf{u}_t = S \varepsilon_t, \qquad \mathbb{E}[\varepsilon_t \varepsilon_t'] = I_n, \qquad \text{de modo que} \quad \Sigma = S S'. \tag{3.10}\]
Aquí \(\varepsilon_t\) son, por ejemplo, un choque de demanda y un choque de política monetaria, y la matriz de impacto \(S\) dice cuánto mueve cada choque a cada variable en el momento cero. El problema es de conteo: \(\Sigma\) ofrece \(n(n+1)/2 = 3\) ecuaciones y \(S\) tiene \(n^2 = 4\) incógnitas, así que faltan \(n(n-1)/2 = 1\) restricciones que los datos no pueden entregar.
La estimación de la forma reducida es un problema estadístico y tiene solución única. La identificación es un problema económico: hay que aportar información que no está en los datos. Todo el Capítulo 4 trata de dónde sacar esas restricciones y de cuánto dependen los resultados de haberlas elegido así.
3.9 Pronóstico con la forma companion
El pronóstico óptimo bajo pérdida cuadrática es la esperanza condicional, y en el VAR se obtiene iterando la Ecuación 3.6 hacia adelante con los choques futuros puestos en su media.
Construir el estado inicial apilado con las últimas \(p\) observaciones:
\[\tilde{\mathbf{y}}_T = (\mathbf{y}_T',\ \mathbf{y}_{T-1}',\ \ldots,\ \mathbf{y}_{T-p+1}')'.\]
Iterar la recursión companion hasta el horizonte deseado y recuperar el vector original con el selector \(J\):
\[\hat{\tilde{\mathbf{y}}}_{T+h|T} = \tilde{c} + F\, \hat{\tilde{\mathbf{y}}}_{T+h-1|T}, \qquad \hat{\mathbf{y}}_{T+h|T} = J\, \hat{\tilde{\mathbf{y}}}_{T+h|T}.\]
Acumular la matriz de error cuadrático medio con los pesos de Wold:
\[\operatorname{ECM}_h = \sum_{j=0}^{h-1} \Psi_j\, \Sigma\, \Psi_j', \qquad \Psi_j = J F^j J'.\]
Formar el intervalo al 95 % para cada variable \(i\):
\[\hat{y}_{i,T+h|T} \pm 1.96\,\sqrt{\big[\operatorname{ECM}_h\big]_{ii}}.\]
h = len(future)
paths, variances = var.forecast(y, fit["B"], fit["Sigma"], p, h)
sd_h = np.sqrt(variances)

hist = sample.iloc[-32:]
hist_dates = hist.index.to_timestamp(how="end")
fc_dates = future.index.to_timestamp(how="end")
edge_dates = np.r_[hist_dates[-1:], fc_dates]

size = figsize(0.66)
fig, axes = plt.subplots(2, 1, sharex=True, figsize=size)
labels = ["inflación (%)", "tasa de referencia (%)"]
for i, (ax, label) in enumerate(zip(axes, labels)):
    last = y[-1, i]
    band = [(np.r_[last, paths[:, i] - 1.96 * sd_h[:, i]],
             np.r_[last, paths[:, i] + 1.96 * sd_h[:, i]])]
    band_labels = ["IC 95 %"] if i == 0 else None
    charts.fan_chart(ax, hist_dates, hist.iloc[:, i],
                     edge_dates, band, np.r_[last, paths[:, i]],
                     realized=future.iloc[:, i],
                     dates_realized=fc_dates,
                     band_labels=band_labels)
    ax.axvline(hist_dates[-1], color=PALETTE["muted"],
               lw=0.8, ls=(0, (3, 2)), zorder=1)
    ax.set_ylabel(label)
top = axes[0].get_ylim()[1]
axes[0].annotate("pronóstico", xy=(edge_dates[2], top),
                 xytext=(0, -10), textcoords="offset points",
                 fontsize=7.5, color=PALETTE["muted"])
charts.legend_outside(axes[0], ncol=4)
plt.show()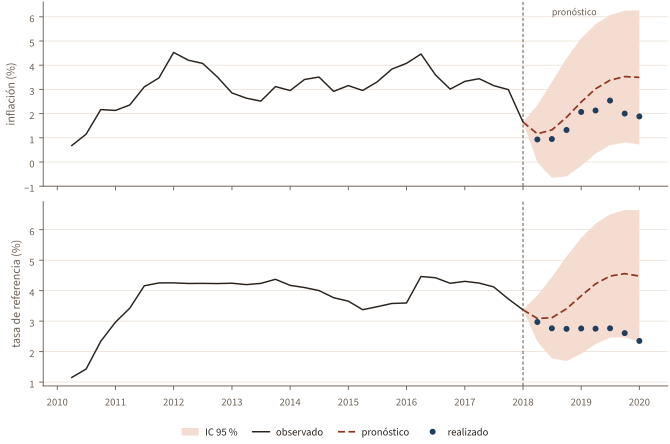
Los dos años reservados permiten una evaluación mínima: qué tan lejos quedó el pronóstico puntual y con qué frecuencia el intervalo contuvo al dato.
actual = future.to_numpy()
error = actual - paths
rmse = np.sqrt((error ** 2).mean(axis=0))
inside = (np.abs(error) <= 1.96 * sd_h).mean(axis=0)

pct = [f"{x:.0%}" for x in inside]

print(f"RMSE a 8 trimestres: π {rmse[0]:.2f}, r {rmse[1]:.2f}")
print(f"dentro del IC 95 %: π {pct[0]}, r {pct[1]}")
RMSE a 8 trimestres: π 0.94, r 1.38
dentro del IC 95 %: π 100%, r 100%El pronóstico no se equivoca al azar. Sobreestima las dos series, el error crece con el horizonte y la Figura 3.5 muestra por qué: con el sistema estable, la proyección converge a la media incondicional implícita, \(\hat{\mu} = (2.94,\ 3.92)\), mientras que la economía de 2018 y 2019 se quedó en un régimen de inflación cerca de 2 % con la tasa de referencia alrededor de 2.75 %. A ocho trimestres el pronóstico de la tasa erra por más de dos puntos porcentuales, y los ocho errores tienen el mismo signo.
Los ocho datos caen dentro del intervalo al 95 %, y eso no es evidencia de que el intervalo esté bien calibrado: son ocho observaciones correlacionadas entre sí, con las que no se distingue una cobertura de 95 % de una de 100 %. El intervalo tampoco es exigente. A ocho trimestres mide casi tres puntos porcentuales hacia cada lado para la inflación, un rango que la serie no iba a abandonar. Que sea ancho y aun así optimista es el punto del recuadro siguiente.
El intervalo trata \(\hat{B}\) y \(\hat{\Sigma}\) como si fueran los valores verdaderos, de modo que subestima la incertidumbre. El sesgo crece cuando la muestra es corta o el sistema es grande, justo donde más importa. La versión honesta integra sobre la distribución de los parámetros, que es lo que hace el pronóstico por densidad del Capítulo 5.
Queda una decisión de reporte: el nivel. En pronóstico frecuentista lo habitual es 90 % o 95 %, y los abanicos de banca central muestran varios tramos hasta el 90 %. Las bandas al 68 %, tan frecuentes en la literatura de VAR estructurales, vienen de otra tradición: son intervalos de una desviación estándar, popularizados por Sims y Zha (1999), que argumentaron que en muestras cortas el 95 % queda tan ancho que no disciplina nada. La crítica moderna es que esas bandas ni son intervalos de confianza al 68 % en sentido estricto ni son simultáneas a lo largo del horizonte, de modo que la cobertura conjunta es bastante menor de lo que el número sugiere (Montiel Olea y Plagborg-Møller 2019). La regla del libro: declarar el nivel, decir si es puntual o simultáneo, y no cambiarlo de capítulo en capítulo para que la figura se vea mejor.
3.10 Otros temas del VAR clásico
Lo que sigue son cuestiones estándar de la práctica con VAR que este libro no desarrolla, porque están bien tratadas en los manuales y porque el hilo del texto va hacia la identificación y los métodos bayesianos. Van aquí los criterios que conviene tener presentes y la referencia donde estudiarlos.
Selección de rezagos
Los criterios de información penalizan el ajuste por el número de parámetros: AIC penaliza \(2k\), el de Hannan y Quinn \(2k\ln(\ln T)\), con el logaritmo aplicado dos veces, y el bayesiano (BIC o SIC) \(k\ln T\). El BIC es consistente para el orden verdadero y el AIC no, pero el AIC suele elegir modelos que pronostican mejor en muestras cortas, así que la elección depende del objetivo. Dos reglas prácticas: comparar siempre sobre la misma muestra efectiva, porque cambiar \(p\) cambia el número de observaciones utilizables; y, si el fin es el análisis de impulso-respuesta con datos trimestrales, seguir a Ivanov y Kilian (2005), que recomiendan AIC en esa configuración y HQ en muestras largas o en frecuencia mensual. Con datos trimestrales, \(p = 4\) es el punto de partida habitual y \(p = 2\) una elección defendible cuando la muestra es corta. Véase Lütkepohl (2005, cap. 4).
Diagnóstico de residuos
El supuesto que hay que vigilar es la ausencia de autocorrelación, porque de él depende que los rezagos incluidos basten para blanquear el error. Se contrasta con un estadístico Portmanteau (Ljung-Box multivariado) o con la prueba LM de Breusch y Godfrey. La normalidad se examina con una versión multivariada de Jarque-Bera, y conviene recordar que no es necesaria para la consistencia: sólo afecta a la inferencia en muestras pequeñas. La heterocedasticidad condicional se detecta con ARCH-LM y se modela en el Capítulo 9. Para la estabilidad de los coeficientes existen pruebas de quiebre y estadísticos CUSUM, y el tratamiento explícito está en el Capítulo 10. Buena práctica: ante autocorrelación residual, agregar rezagos antes que cambiar de modelo. Véase Lütkepohl (2005, cap. 4).
Niveles, diferencias y cointegración
Conviene separar dos decisiones que suelen confundirse. La primera es qué variable económica interesa: el nivel de precios o la inflación, el PIB o su tasa de crecimiento. Esa elección es sustantiva y viene antes que la econometría; en este capítulo interesan la inflación y la tasa de política, no el índice de precios. La segunda, ya fijadas las variables, es si las series que entran al sistema tienen raíz unitaria y qué hacer al respecto. La discusión que sigue es sobre la segunda.
- Variables con tendencia estocástica, estimadas en niveles. Mínimos cuadrados sigue siendo consistente y las respuestas de corto plazo no se distorsionan, pero la inferencia sobre funciones de largo plazo deja de ser estándar y algunos estadísticos ya no son asintóticamente normales (Sims et al. 1990). Es lo que hace la mayor parte de la literatura estructural desde Sims (1980), con un argumento claro: si las series comparten una relación de equilibrio, diferenciarlas la destruye.
- Variables con tendencia estocástica, en diferencias o con cointegración explícita. Si el objeto de interés es esa relación de largo plazo, el modelo correcto es el VECM, que separa el ajuste de corto plazo del equilibrio; diferenciar sin el término de corrección de error pierde el equilibrio, y dejarlo implícito en un VAR en niveles complica la inferencia sobre él. El número de vectores de cointegración se contrasta con el procedimiento de máxima verosimilitud de Johansen (1995), sobre la representación de Engle y Granger (1987).
Este capítulo no está en ninguno de los dos casos, y vale la pena ver por qué. La inflación interanual es una transformación del IPC, pero no es la variable original diferenciada para forzar estacionariedad: es la variable que el banco central controla y sobre la que anuncia su meta. Lo mismo la tasa de referencia, que es un nivel. Ninguna de las dos es candidata natural a raíz unitaria bajo un régimen de metas, y el módulo máximo de las raíces estimadas (0.84) es compatible con ello, aunque mínimos cuadrados sesga las raíces hacia abajo en muestras de este tamaño. La discusión anterior se vuelve inevitable cuando al sistema entran el producto, el tipo de cambio o los precios en logaritmos. Para el tratamiento completo, Lütkepohl (2005, caps. 6-8).
Tamaño del sistema
La decisión que más determina los resultados no es el orden de rezagos sino qué variables entran. Un VAR pequeño y bien argumentado suele ser preferible a uno grande estimado sin restricciones, y cuando el sistema debe crecer la respuesta no es eliminar variables sino encogerlas: eso es el Capítulo 5.
Ideas clave
- El VAR es un dispositivo de resumen de la dinámica conjunta: describe correlaciones dinámicas, no efectos causales.
- Las tres representaciones son el mismo modelo: la compacta sirve para estimar y la companion para proyectar y para estudiar la estabilidad. El Capítulo 5 agrega una cuarta, la vectorizada, cuando hace falta enlazar las ecuaciones.
- La estabilidad es una propiedad de los valores propios de la companion, y es lo que permite hablar de media incondicional, de representación de Wold y de respuestas que se disipan.
- Con los mismos regresores en todas las ecuaciones, mínimos cuadrados ecuación por ecuación no deja nada sobre la mesa; con priors o restricciones cruzadas, sí.
- \(\Sigma\) no es diagonal, y por eso los residuos de la forma reducida no se pueden mover de a uno: sin una hipótesis de identificación no hay impulso-respuesta con interpretación causal.
Lecturas recomendadas
- Sims (1980)
- El artículo que inició el programa; conviene leer la crítica a las restricciones increíbles de los modelos de ecuaciones simultáneas.
- Stock y Watson (2001)
- Revisión breve y honesta de lo que un VAR puede y no puede hacer.
- Lütkepohl (2005), caps. 2 y 3
- El tratamiento completo de la forma companion, la estabilidad y la inferencia asintótica.
- Kilian y Lütkepohl (2017), cap. 2
- La misma materia con el énfasis puesto en lo que hará falta para el capítulo siguiente.
- Sims y Zha (1999)
- El origen de las bandas al 68 % y el argumento a su favor.
Ejercicios
Ejercicio 3.1 Escriba a mano la matriz companion de un VAR(3) con dos variables y verifique en Python que iterarla reproduce el pronóstico obtenido por recursión directa sobre la Ecuación 3.1.
Ejercicio 3.2 Estime el VAR con \(p = 1, 2, 3, 4\) sobre la misma muestra efectiva y compare AIC, BIC y el módulo máximo de las raíces. ¿Coinciden los criterios? ¿Cambia alguna conclusión sobre la persistencia del sistema?
Ejercicio 3.3 Reestime el modelo extendiendo la muestra hasta 2019Q4, es decir agregando las ocho observaciones que aquí se reservaron. Compare los coeficientes, la correlación entre innovaciones y el ancho del intervalo a ocho trimestres. ¿Cuánto mueven ocho observaciones a un sistema estimado con 57?
Ejercicio 3.4 Calcule \(\hat{\mu} = (I - \hat{\Phi}_1 - \hat{\Phi}_2)^{-1}\hat{c}\) y compárela con el promedio muestral de cada serie. ¿Por qué la media implícita se estima mejor que el intercepto? Compare también \(\hat{\mu}_\pi\) con la meta de inflación del BCRP.
Ejercicio 3.5 Simule con var.simulate un sistema con los coeficientes estimados pero con \(\sigma_{12} = 0\), y vuelva a estimar. ¿Cambian los coeficientes? ¿Cambia lo que se puede afirmar sobre el efecto de un choque de tasa? Use el resultado para explicar por qué la identificación es un problema aparte de la estimación.
Ejercicio 3.6 Tome \(\hat{\Phi}_1\) y multiplíquelo por un escalar creciente hasta que el módulo máximo de los valores propios pase de uno. Simule el sistema justo antes y justo después del umbral y grafique las trayectorias. ¿Qué cambia en la escala del eje vertical?