¿Qué parte del movimiento conjunto de las series podemos atribuir a un choque económico concreto?
Plantear el problema de identificación con precisión y contar cuántas restricciones hacen falta.
Identificar los choques por orden recursivo, por efectos de largo plazo o por signos, y leer las respuestas, la varianza y la historia que resultan.
Reconocer qué parte de la incertidumbre reportan las bandas y cuál no.
Requisitos previos.Capítulo 3; la factorización de Cholesky y las matrices ortogonales (sección 0.5); el bootstrap (0.11); nociones de identificación en modelos de ecuaciones simultáneas.
Serie
Fuente
Frecuencia
Transformación
Inflación (\(\pi_t\))
BEA
trimestral
\(400\ln(P_t/P_{t-1})\), deflactor del PBI
Desempleo (\(u_t\))
BLS
trimestral
tasa civil, promedio del trimestre
Tasa de fondos federales (\(R_t\))
Reserva Federal
trimestral
promedio del trimestre
Los datos de Estados Unidos entre 1960T1 y 2000T4 son los del material de replicación de Stock y Watson (2001): data/raw/SW2001_Data.xlsx. La Sección 4.8 usa además la muestra de Blanchard y Quah (1989) (data/raw/BQ1989_Data.xlsx). Ambos CSV los construye code/python/build_us_data.py.
4.1 De los residuos a los choques
El Capítulo 3 terminó en un callejón deliberado. La forma reducida describe bien la dinámica conjunta, pronostica de manera razonable y no permite responder la pregunta que interesa a quien decide la política: qué pasa con la inflación y el desempleo si la tasa sube por una decisión propia del banco central y no como respuesta a lo que el banco central observa. El obstáculo es que los residuos \(\mathbf{u}_t\) son errores de pronóstico correlacionados entre sí, no experimentos.
La salida es suponer que esas sorpresas observadas son combinaciones lineales de un número igual de choques no observados con significado económico.
Supuesto 4.1 · Choques estructurales Existe una matriz \(S\) de \(n \times n\), invertible, y un vector de choques estructurales \(\varepsilon_t\) tal que
\[ \mathbf{u}_t = S \varepsilon_t, \qquad \mathbb{E}[\varepsilon_t] = 0, \qquad \mathbb{E}[\varepsilon_t \varepsilon_t'] = I_n, \qquad \mathbb{E}[\varepsilon_t \varepsilon_s'] = 0 \ \text{ para } t \neq s. \]
Los choques son ortogonales entre sí y están normalizados a varianza unitaria, de modo que mover uno dejando los demás en cero es una operación bien definida. La columna \(k\) de \(S\) recoge el efecto contemporáneo del choque \(k\) sobre cada variable.
La normalización a varianza unitaria no tiene contenido: reescalar \(\varepsilon_{kt}\) y dividir la columna \(k\) de \(S\) por el mismo número deja el modelo igual. Lo que sí tiene contenido es la ortogonalidad, porque es la que permite hablar de un choque a la vez, y es también la que hace falta interpretar: dos choques ortogonales en el modelo son dos fuerzas que en la economía no se mueven juntas por construcción, y eso hay que argumentarlo.
Sustituyendo el supuesto en la forma reducida,
\[ \mathbf{y}_t = c + \Phi_1 \mathbf{y}_{t-1} + \cdots + \Phi_p \mathbf{y}_{t-p} + S \varepsilon_t . \tag{4.1}\]
La Ecuación 4.1 es el VAR estructural. Tiene dos piezas con estatus distinto. Las matrices \(\Phi_\ell\) son la dinámica, y se estiman por mínimos cuadrados como en la Sección 3.7. La matriz \(S\) es el impacto, no se estima con los datos solos y es donde entra la economía.
El SVAR puede leerse como una aproximación lineal a la solución de un modelo estructural: la dinámica resume cómo se propagan las perturbaciones y la matriz de impacto dice quién empuja a quién en el momento cero. La diferencia con un DSGE es de dónde vienen las restricciones: allá, de la forma completa del modelo; aquí, de unos pocos supuestos que se declaran uno por uno.
4.2 El problema de identificación
Los datos informan sobre \(\Sigma\), no sobre \(S\). La relación entre ambos sale del supuesto:
\[ \Sigma = \mathbb{E}[\mathbf{u}_t \mathbf{u}_t'] = \mathbb{E}[S \varepsilon_t \varepsilon_t' S'] = S\, \mathbb{E}[\varepsilon_t \varepsilon_t']\, S' = S S' . \tag{4.2}\]
Identificar es resolver la Ecuación 4.2 para \(S\). El problema es de conteo.
Proposición 4.1 · Grados de libertad de la identificación\(\Sigma\) es simétrica, de modo que aporta \(n(n+1)/2\) ecuaciones distintas, mientras que \(S\) tiene \(n^2\) incógnitas. Hacen falta
\[ n^2 - \frac{n(n+1)}{2} = \frac{n(n-1)}{2} \]
restricciones adicionales para que la solución sea única, y esas restricciones no pueden venir de los datos: cualquier \(\tilde{S} = S Q\) con \(Q\) ortonormal reproduce exactamente la misma \(\Sigma\) y, por lo tanto, la misma verosimilitud.
Con dos variables, como en el sistema con el que empieza este capítulo, falta una restricción; con tres, como en el de Stock y Watson, faltan tres; con siete variables, veintiuna. El último punto de la Proposición 4.1 es el que conviene grabar: el conjunto de matrices de impacto compatibles con los datos no es pequeño ni raro, es una variedad continua del mismo tamaño que el grupo ortogonal, y todos sus elementos ajustan los datos igual de bien. Ninguna prueba estadística puede escoger entre ellos.
Que dos modelos ajusten igual no significa que digan lo mismo. Dos matrices de impacto distintas compatibles con la misma \(\Sigma\) pueden implicar que la política monetaria contrae el producto o que lo expande. La elección entre ellas es un supuesto económico que el investigador declara y defiende, no un resultado que los datos entreguen. Por eso un SVAR se reporta siempre junto con su esquema de identificación, y por eso la sensibilidad a ese esquema es parte del resultado.
Las secciones siguientes recorren los tres esquemas más usados: restricciones de cero contemporáneas, restricciones de cero de largo plazo y restricciones de signo. Cada uno aporta la información que falta de una manera distinta, y cada uno cuesta algo.
Un sistema de dos variables
El capítulo usa los datos de Stock y Watson (2001) del Capítulo 3: inflación, desempleo y tasa de fondos federales de Estados Unidos, trimestrales de 1960T1 a 2000T4 (Figura 3.2). Para ver la identificación con el álgebra a la vista conviene empezar con dos de las tres series, la inflación y la tasa, y un VAR(2): un choque de la economía, uno de la política y una sola restricción por imponer. La Sección 4.4 agrega el desempleo y vuelve al sistema de Stock y Watson, que tiene una ventaja para el análisis estructural: cada resultado se puede contrastar con una cifra publicada. El Ejercicio 4.6 lleva el análisis a los datos peruanos del Ejercicio 3.7.
import numpy as npimport pandas as pdfrom macrobook import data_path, var, svarcsv = data_path("sw2001.csv")data = pd.read_csv(csv, index_col="date")data.index = pd.PeriodIndex(data.index, freq="Q")order2 = ["infl", "ff"] # the two-variable systemy2 = data[order2].to_numpy()p2 =2fit2 = var.ols(y2, p2)root2 = np.abs(var.roots(fit2["B"], 2, p2)).max()corr2 = np.corrcoef(fit2["residuals"].T)[0, 1]print("muestra:", data.index[0], "a", data.index[-1])print("módulo máximo de las raíces:", root2.round(3))print("correlación de las innovaciones:", corr2.round(2))
muestra: 1960Q1 a 2000Q4
módulo máximo de las raíces: 0.904
correlación de las innovaciones: 0.15
El sistema es estable, con un módulo máximo de 0.90. Las innovaciones de la inflación y de la tasa tienen una correlación de 0.15: cuando la inflación sorprende al alza, la tasa también lo hace dentro del mismo trimestre. Es lo que se espera de un banco central que reacciona a los precios, y es también la razón por la que esa correlación no mide el efecto de la política sobre la inflación.
4.3 Identificación recursiva
El esquema más antiguo y todavía el más usado impone ceros en la matriz de impacto (Sims 1980; Christiano et al. 1999). La idea es ordenar las variables de la más lenta a la más rápida en reaccionar dentro del período, y suponer que cada variable no responde contemporáneamente a los choques de las que vienen después.
Con el orden \((\pi_t, R_t)\) la matriz de impacto del sistema bivariado es triangular inferior:
El cero es la \(n(n-1)/2 = 1\) restricción que faltaba. Dice que el choque de política no mueve la inflación dentro del mismo trimestre, porque los precios tardan en reaccionar. A cambio deja libre \(s_{21}\), de modo que la tasa sí responde dentro del trimestre a la inflación, que es lo que hace un banco central que mira los datos al decidir. El orden contrario, \((R_t, \pi_t)\), diría lo opuesto: un banco central que no ve la inflación del trimestre y una inflación que reacciona de inmediato a la tasa.
Las dos mitades del supuesto le piden cosas opuestas a la frecuencia de los datos. Que la política no toque los precios es más creíble cuanto más corto el período: durante un mes es más fácil de aceptar que durante tres. Que el banco central reaccione a la inflación del período funciona al revés: dentro de un mes todavía no la conoce, y dentro de un trimestre ya conoce buena parte. Con datos trimestrales, como aquí, la mitad que hay que defender es la primera.
Proposición 4.2 · Identificación recursiva Si \(S\) es triangular inferior con diagonal positiva, entonces \(S\) es el único factor de Cholesky de \(\Sigma\), esto es, la única matriz triangular inferior con diagonal positiva que cumple \(\Sigma = S S'\).
Ejemplo 4.1 · Cholesky a mano Con \(\hat{\Sigma} = \begin{bmatrix} 4 & 2 \\ 2 & 10 \end{bmatrix}\), igualar \(\hat{\Sigma} = S S'\) con \(S\) triangular inferior da tres ecuaciones:
Resolviendo en cadena, \(s_{11} = 2\), \(s_{21} = 1\) y \(s_{22} = 3\). Tres ecuaciones y tres incógnitas: la triangularidad convirtió un problema indeterminado en uno exactamente identificado.
La segunda columna es el choque de política: eleva la tasa de fondos federales en 0.97 puntos porcentuales en el trimestre del choque y, por construcción, no toca la inflación en ese momento. El elemento \(s_{21}\) es el que da contenido al orden: un choque de inflación de una desviación estándar, que sube la inflación 1.04 puntos, sube la tasa 0.15 dentro del mismo trimestre, como lo haría una regla que reacciona a los precios. El primer choque lleva el nombre de la variable que encabeza, no el de una interpretación económica, y conviene que sea así: el orden identifica con un argumento defendible el choque de política y deja al otro como lo que queda. Ponerle nombre de choque de oferta o de demanda exigiría un argumento adicional que este esquema no aporta.
El orden de las variables es una restricción económica, no una convención de programación. Cambiarlo cambia los choques y puede cambiar las conclusiones. La práctica mínima es reportar el orden elegido, justificarlo y mostrar qué pasa con otro orden razonable. Cuando el resultado depende del orden, lo que hay que reportar es esa dependencia, no el orden más favorable.
4.4 Funciones de impulso-respuesta
Identificada la matriz de impacto, el resto es aritmética de la forma companion.
Definición 4.1 · Función de impulso-respuesta La respuesta de las variables al choque estructural \(k\) al cabo de \(h\) períodos es
donde \(F\) es la matriz companion y \(J\) el selector de la Sección 3.5. El elemento \((i,k)\) de \(\Theta_h\) es la respuesta de la variable \(i\) al choque \(k\) en el horizonte \(h\), manteniendo los demás choques en cero.
La derivación es la sustitución recursiva de siempre. Partiendo de \(\mathbf{y}_t = \Phi_1 \mathbf{y}_{t-1} + S\varepsilon_t\) e iterando hacia adelante, el término que sobrevive del choque de hoy en \(t+h\) es \(\Phi_1^h S \varepsilon_t\); con \(p > 1\), la potencia de la companion hace el mismo trabajo.
Ejemplo 4.2 · Una respuesta calculada a mano Con \(\hat{\Phi} = \begin{bmatrix} 0.5 & 0.1 \\ 0.2 & 0.4 \end{bmatrix}\) y \(\hat{S} = \begin{bmatrix} 2 & 0 \\ 1 & 3 \end{bmatrix}\), un choque unitario al primer elemento da
La respuesta decae porque el sistema es estable. En un sistema inestable esta misma recursión explota, que es la razón práctica por la que la estabilidad se verifica antes de graficar nada.
La escala del choque es una convención más. Un choque de una desviación estándar es el tamaño natural en los datos; un choque unitario, que se obtiene dividiendo la columna \(k\) de \(S\) por \(s_{kk}\), hace que el choque mueva a su propia variable exactamente un punto porcentual y es más fácil de comunicar. Stock y Watson (2001) usan el segundo y aquí se hace lo mismo.
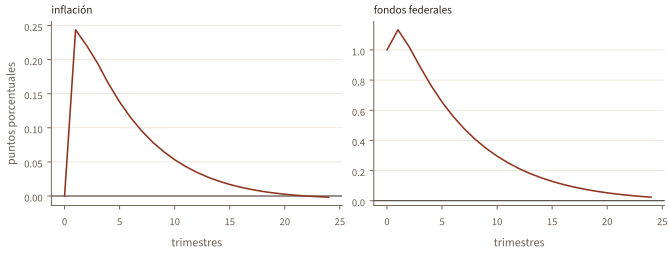
Figura 4.1: Sistema bivariado: respuestas de la inflación y de la tasa a un choque de política de un punto porcentual.
La tasa sube un punto y vuelve despacio. La inflación sube 0.24 puntos en el trimestre siguiente y se queda por encima de cero durante 5 años. Tomado al pie de la letra, el sistema bivariado dice que subir la tasa sube la inflación: es el price puzzle de la Sección 3.8 en su forma más cruda. La explicación más probable es una variable omitida. El banco central sube la tasa cuando ve una economía recalentada que anuncia más inflación, y un sistema sin ninguna variable de actividad no puede distinguir esa reacción de un choque de política: le atribuye al choque la inflación que el ciclo ya traía (Sims 1992).
El sistema de Stock y Watson
Stock y Watson (2001) agregan el desempleo, ordenado entre la inflación y la tasa, y usan cuatro rezagos. La matriz de impacto pasa a ser
con las \(n(n-1)/2 = 3\) restricciones que ahora faltan. Repiten la lógica del caso bivariado: la tasa responde dentro del trimestre a la inflación y al desempleo, y el choque de política no mueve a ninguno de los dos en ese trimestre. El desempleo, en el medio, responde dentro del trimestre a la inflación pero no a la tasa.
order = ["infl", "unemp", "ff"]sample = data[order]dates = sample.index.to_timestamp(how="end")y = sample.to_numpy()n, p =len(order), 4names = ["inflación", "desempleo", "tasa"]labels = ["inflación (%)", "desempleo (%)","fondos federales (%)"]fit = var.ols(y, p)max_root = np.abs(var.roots(fit["B"], n, p)).max()print("módulo máximo de las raíces:", max_root.round(3))
módulo máximo de las raíces: 0.969
La muestra cubre la Gran Inflación de los años setenta, la desinflación de Volcker y la larga expansión de los noventa. El módulo máximo de las raíces, 0.97, más alto que el del sistema bivariado, avisa de entrada que el sistema es muy persistente: las respuestas van a decaer despacio y las bandas a horizontes largos serán anchas.
La matriz de covarianzas de los residuos vuelve a ser el objeto central. Conviene mirarla en correlaciones, que se leen más rápido.
La correlación más fuerte es la de −0.45 entre la sorpresa de desempleo y la sorpresa de tasa: cuando el desempleo sorprende al alza, la tasa sorprende a la baja. Es lo que se espera de una regla de política que reacciona al ciclo, y es justamente la información que le faltaba al sistema bivariado.
S = np.linalg.cholesky(fit["Sigma"])shocks = ["inflación", "desempleo", "política"]theta = svar.responses(fit["B"], svar.unit_scale(S), n, p, 24)pd.DataFrame(S.round(3), index=order, columns=shocks)
inflación
desempleo
política
infl
0.985
0.000
0.000
unemp
-0.013
0.226
0.000
ff
0.109
-0.395
0.784
La tercera columna es el choque de política: eleva la tasa de fondos federales en 0.78 puntos porcentuales en el trimestre del choque y no toca a la inflación ni al desempleo en ese momento. El elemento \(s_{32}\), igual a −0.39, dice que ante un choque de desempleo de una desviación estándar la tasa baja dentro del mismo trimestre, como lo haría siguiendo una regla. La última línea calcula las respuestas a choques unitarios, theta, con las que trabaja el resto del capítulo.
4.5 Bandas de confianza
Las respuestas son funciones no lineales de los coeficientes estimados, así que su distribución muestral no tiene forma cerrada útil. La práctica estándar es el bootstrap (Kilian y Lütkepohl 2017, cap. 12), en la versión de diseño recursivo del Algoritmo 4.1.
Algoritmo 4.1: Bandas bootstrap para las respuestas estructurales
Estimar el VAR y guardar \(\hat{B}\), \(\hat{\Sigma}\) y los residuos \(\hat{\mathbf{u}}_t\).
Remuestrear con reemplazo los residuos para obtener \(\hat{\mathbf{u}}_t^{*}\), y construir una muestra artificial recursivamente, con las mismas \(p\) observaciones iniciales:
Reestimar el VAR sobre \(\mathbf{y}^{*}\), volver a identificar y calcular \(\Theta_h^{*}\). Repetir \(N\) veces.
Reportar los percentiles \(2.5\) y \(97.5\) de los \(\Theta_h^{*}\) en cada horizonte.
El paso 2 es el que suele salir mal. Un atajo tentador es sumar los residuos remuestreados a los valores ajustados, \(\mathbf{y}_t^{*} = \hat{\mathbf{y}}_t + \hat{\mathbf{u}}_t^{*}\), y reestimar el VAR con los rezagos de \(\mathbf{y}^{*}\). Con eso los regresores ya no son los que generaron la muestra: cada rezago de \(\mathbf{y}^{*}\) arrastra un ruido que la ecuación no contiene, y el estimador bootstrap se sesga hacia cero en la persistencia, como cualquier regresión con error de medida en los regresores. Existe una variante válida que no itera, el diseño fijo, que reutiliza los rezagos originales como regresores (Gonçalves y Kilian 2004); lo que no hace es reproducir el sesgo de mínimos cuadrados en muestras cortas, que el diseño recursivo sí reproduce.
Ese sesgo es el de la sección 0.11: con raíces cerca de uno, mínimos cuadrados subestima la persistencia. Kilian (1998) corrige las bandas por él con un bootstrap previo que estima el sesgo y lo descuenta; la versión de este capítulo es la más simple, percentil y sin corrección, y el Ejercicio 4.9 pide la otra.
lower, upper = svar.bootstrap_bands( y, p, h=24, draws=2000, level=0.95, unit=True, seed=7)print("respuesta del desempleo en h=8:")print(" punto %.2f"% theta[8, 1, 2])print(" banda [%.2f, %.2f]"% (lower[8, 1, 2], upper[8, 1, 2]))
respuesta del desempleo en h=8:
  punto  0.20
  banda [0.11, 0.30]
resp = [[theta[:, i, k] for k inrange(n)] for i inrange(n)]bands = [[[(lower[:, i, k], upper[:, i, k])] for k inrange(n)]for i inrange(n)]fig, axes = charts.irf_grid(resp, labels, shocks, bands=bands)axes[-1][1].set_xlabel("trimestres")plt.show()
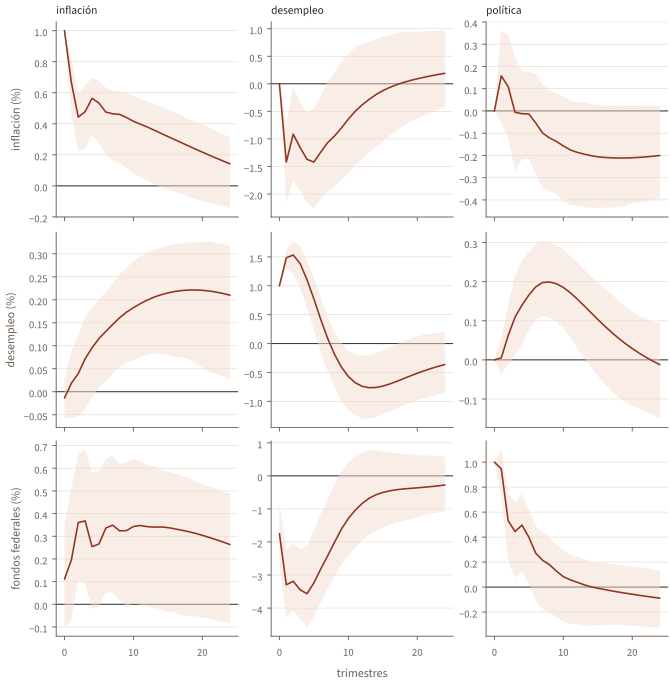
Figura 4.2: Respuestas a un choque unitario bajo identificación recursiva, con bandas bootstrap al 95 %. Las filas son variables y las columnas, choques. Es la Figura 1 de Stock y Watson (2001) traspuesta, con bandas más anchas: el artículo traza ±1 error estándar.
La fila del desempleo, en la columna de la derecha, reproduce el resultado central de Stock y Watson (2001). Un aumento de un punto porcentual en la tasa de fondos federales eleva el desempleo, que alcanza un máximo de 0.20 puntos a los 8 trimestres, con una banda de 0.11 a 0.30, y vuelve a cero en el sexto año. El signo, la forma de joroba y el rezago de dos años son los hechos estilizados que la literatura de política monetaria reporta desde entonces.
La respuesta de la inflación es el punto incómodo: sube 0.16 puntos en el trimestre siguiente al choque, se vuelve negativa desde el trimestre 3 y se estabiliza alrededor de −0.21, pero su banda al 95 % contiene al cero en todos los horizontes. Es el price puzzle del sistema bivariado (Figura 4.1), más débil pero no resuelto. Parte de la mejora viene del desempleo y parte de los rezagos: con dos rezagos en los dos sistemas, agregar el desempleo reduce la subida inicial de 0.24 a 0.13 puntos y adelanta el cambio de signo del trimestre 22 al 6. Lo que queda tiene la lectura estándar: el banco central reacciona a información sobre precios futuros que el sistema no contiene, de modo que parte de lo que el esquema llama choque de política es en realidad la respuesta a una presión inflacionaria que el VAR no ve (Sims 1992; Christiano et al. 1999). El remedio usual es ampliar el sistema con un índice de precios de materias primas, que actúa como indicador adelantado de la inflación.
El nivel de la banda decide aquí la lectura. Stock y Watson (2001) trazan un error estándar a cada lado, cerca de un 68 % de cobertura; con la banda bootstrap al 68 %, la de la inflación queda entera por debajo de cero desde el trimestre 8, y al 95 % no lo hace en ningún horizonte. Por eso el nivel se declara siempre, como se discutió en la Sección 3.9.
La banda bootstrap recoge la incertidumbre de estimación de \(\hat{B}\) y \(\hat{\Sigma}\), y nada más. La incertidumbre sobre el esquema de identificación, que suele ser mayor, queda fuera por construcción: la banda se calcula manteniendo fijo el supuesto de triangularidad. Una banda estrecha alrededor de una respuesta mal identificada es precisión sobre el objeto equivocado.
4.6 Descomposición de varianza
La impulso-respuesta dice cómo se mueve el sistema ante un choque. La descomposición de varianza dice cuánto importa ese choque en promedio.
La descomposición de varianza no depende de cómo se escale el choque, así que aquí se vuelve a las respuestas de una desviación estándar.
Definición 4.2 · Descomposición de varianza del error de pronóstico El error de pronóstico a \(h\) períodos es \(\mathbf{y}_{t+h} - \mathbb{E}_t[\mathbf{y}_{t+h}] = \sum_{j=0}^{h-1} \Theta_j \varepsilon_{t+h-j}\). Como los choques son ortogonales y de varianza unitaria, la varianza del error de la variable \(i\) se parte sin residuo entre los choques:
A un período, \(h = 1\), sólo entra el impacto \(\Theta_0 = S\): con la identificación recursiva la primera variable se explica entera por su propio choque. En el código, la suma acumulada hasta la fila \(j\) corresponde al horizonte \(h = j + 1\).
Ejemplo 4.3 · Descomposición de varianza con dos variables Con las matrices del Ejemplo 4.2, las dos primeras respuestas son \(\Theta_0 = \hat{S}\) y \(\Theta_1 = \hat{\Phi}\hat{S}\):
El error de pronóstico a dos períodos de la primera variable suma los choques de \(t+2\), que entran con \(\Theta_0\), y los de \(t+1\), que entran con \(\Theta_1\):
Los cuatro choques son independientes y de varianza uno, así que la varianza es la suma de los cuadrados de los coeficientes, \(4 + 0 + 1.21 + 0.09 = 5.30\), y cada choque se queda con los suyos: el primero aporta \(4 + 1.21 = 5.21\), el 98.3 %, y el segundo \(0.09\), el 1.7 %. A un período el primer choque explicaba el 100 %, porque \(\theta_{12,0} = 0\); el segundo entra recién en el horizonte 2, a través de la dinámica. Para la segunda variable las cuentas son \(1 + 0.64 = 1.64\) contra \(9 + 1.44 = 10.44\): el 13.6 % y el 86.4 % a dos períodos, frente al 10 % y el 90 % a uno.
size = figsize(0.40)fig, axes = plt.subplots(1, 3, sharey=True, figsize=size)horizons = np.arange(1, shares.shape[0] +1)for i, (ax, name) inenumerate(zip(axes, names)): ax.stackplot(horizons, shares[:, i, :].T *100, colors=PALETTE["fills"][:n], labels=shocks, edgecolor="white", lw=0.4) ax.set_title(name, fontsize=8.5) ax.set_xlabel("trimestres") ax.set_ylim(0, 100) ax.grid(False, axis="x")axes[0].set_ylabel("% de la varianza")charts.legend_outside(axes[1], ncol=3)plt.show()
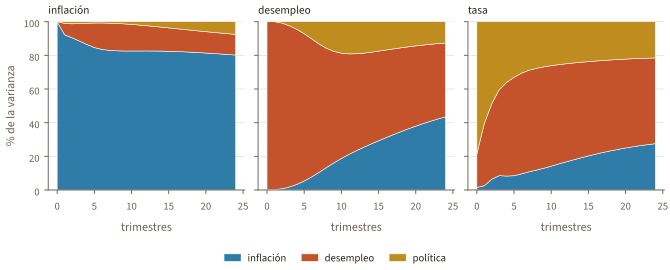
Figura 4.3: Descomposición de la varianza del error de pronóstico por horizonte. Cada panel reparte el 100 % de la varianza de una variable entre los tres choques.
El cuadro de arriba es el Cuadro 1 de Stock y Watson (2001) y sirve para verificar la replicación. La celda siguiente copia las cifras publicadas y mide, para cada variable y horizonte, la mayor diferencia entre los tres choques.
Las dos descomposiciones coinciden dentro de un punto para la inflación y la tasa en todos los horizontes, y dentro de dos para el desempleo a uno y cuatro trimestres. La diferencia está en el desempleo a ocho y doce trimestres, de hasta 6 puntos: a doce, el artículo reporta 16, 66 y 18 por ciento, y aquí sale 21, 60 y 19. El modelo, la muestra y el orden son los mismos, así que la sospecha recae en la versión de los datos, y la desviación estándar del error a un trimestre apunta a la inflación: coincide para el desempleo, 0.23 en los dos casos, y no para la inflación, 0.99 aquí contra 0.96 en el artículo. Una convención distinta de grados de libertad escalaría las dos por igual. El deflactor del PBI, a diferencia del desempleo y de la tasa, cambia en cada revisión integral de las cuentas nacionales. Con este archivo no se puede probar, pero vale la pena registrar que una replicación puede ser correcta y aun así no coincidir en el último dígito.
La lectura económica es la misma en ambos casos. El choque de política explica 19 % de la varianza del desempleo a tres años y 2 % de la de la inflación. Es poco, y es un resultado repetido en la literatura: los choques de política monetaria, entendidos como desviaciones respecto de la regla sistemática, explican una fracción pequeña de las fluctuaciones (Christiano et al. 1999; Ramey 2016). La afirmación no es que la política monetaria sea irrelevante, sino que casi todo lo que hace es sistemático, y lo sistemático no es un choque.
4.7 Descomposición histórica
La descomposición de varianza es un promedio sobre toda la muestra. La descomposición histórica baja al detalle de cada trimestre: qué choques explican que la inflación de 1980 haya estado donde estuvo.
Definición 4.3 · Descomposición histórica Usando la representación de Wold estructural, cada observación se escribe como la suma de las contribuciones de los choques pasados más un término determinista y la condición inicial:
\[ \mathbf{y}_t = \underbrace{\text{base}_t}_{\text{media e inicio}} + \sum_{k=1}^{n} \underbrace{\sum_{j=0}^{t-1} \theta_{\cdot k, j}\, \varepsilon_{k,t-j}}_{\text{aporte del choque } k} . \tag{4.7}\]
Los choques se recuperan invirtiendo la matriz de impacto sobre los residuos estimados, \(\hat{\varepsilon}_t = S^{-1}\hat{\mathbf{u}}_t\).
Ejemplo 4.4 · Descomposición histórica con dos variables Con las mismas matrices, sin constante y con \(\mathbf{y}_0 = 0\), la economía recibe un choque del primer tipo en \(t = 1\), \(\varepsilon_1 = (1, 0)'\), uno del segundo en \(t = 2\), \(\varepsilon_2 = (0, 1)'\), y ninguno en \(t = 3\). Iterando \(\mathbf{y}_t = \hat{\Phi}\mathbf{y}_{t-1} + \hat{S}\varepsilon_t\) se llega a
con \(\Theta_2 = \hat{\Phi}^2\hat{S}\). El primer sumando es la primera columna de \(\Theta_2\) y es todo el aporte del choque 1; el segundo es la segunda columna de \(\Theta_1\) y es todo el aporte del choque 2. En \(t = 3\) la primera variable está 0.93 por encima de su base: 0.63 por el choque de hace dos períodos y 0.30 por el de hace uno. Con \(\mathbf{y}_0 \neq 0\) la base sumaría \(\hat{\Phi}^3 \mathbf{y}_0\), la huella de la condición inicial, y con constante también la media. La Ecuación 4.7 hace estas mismas cuentas para cada \(t\), con los choques estimados.
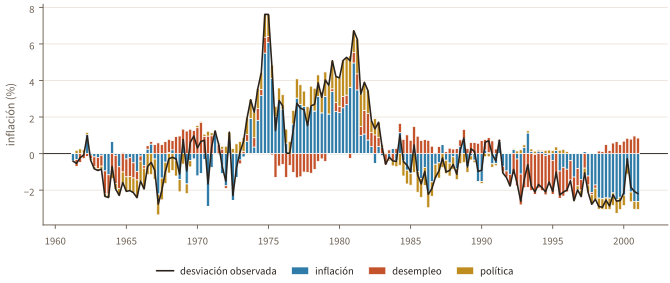
Figura 4.4: Descomposición histórica de la inflación: aporte de cada choque a la desviación respecto de la base del modelo. La línea es la desviación observada.
La Gran Inflación se lee con claridad. Entre 1979 y 1981 la inflación estuvo en promedio 4.7 puntos por encima de la base del modelo, y el gráfico reparte esa desviación entre el choque propio de los precios, que aporta 2.5, el choque de política, que aporta 1.6, y el del desempleo, con 0.5.
El término de la política es una afirmación fuerte y conviene preguntarle de dónde viene. El aporte de un trimestre suma los efectos de todos los choques de política anteriores, y en este caso hay dos candidatos con signos opuestos: los choques expansivos de los setenta, que suben la inflación con rezago, y los contractivos de Volcker desde 1979, que por el price puzzle también la suben durante un par de trimestres antes de bajarla. Para distinguirlos, la descomposición se puede partir por la fecha del choque:
cut =list(periods).index(pd.Period("1979Q1", freq="Q"))window =range(cut, cut +12) # 1979Q1 to 1981Q4w = weights[:, 0, 2] # inflation, policy shockdef policy_part(t, first, last):"""Effect at t of the policy shocks in [first, last).""" dated =range(first, min(last, t +1))returnsum(w[t - s] * eps[s, 2] for s in dated)before = np.mean([policy_part(t, 0, cut) for t in window])since = np.mean([policy_part(t, cut, T_eff) for t in window])print("choques anteriores a 1979: %.2f"% before)print("choques de 1979 en adelante: %.2f"% since)
choques anteriores a 1979: 1.51
choques de 1979 en adelante: 0.11
Casi todo viene de antes: 1.5 de los 1.6 puntos los aportan choques de política anteriores a 1979. El modelo dice que las desviaciones acumuladas respecto de la regla estimada durante los setenta, una política más laxa de lo que la propia regla habría indicado, sostenían todavía esa inflación. Los choques contractivos de 1979 en adelante aportan apenas 0.1 en esos tres años, porque la inflación responde tarde y al principio con el signo equivocado. Su efecto llega después: entre 1983 y 1986 el aporte de la política a la inflación es de −0.7 puntos en promedio, que es como se ve la desinflación de Volcker desde este modelo.
Conviene mirar también las décadas completas: el aporte medio del choque de política a la inflación es de 0.8 puntos en los setenta y de −0.2 en los noventa. Con los mismos coeficientes, el mismo choque cambia de papel según la época.
Las tres lecturas de un SVAR responden preguntas distintas sobre el mismo objeto. La impulso-respuesta es un experimento: qué pasaría si. La descomposición de varianza es un promedio: cuánto importa este choque en general. La descomposición histórica es un relato: qué pasó en este trimestre concreto. Las tres se calculan con las mismas matrices \(\Theta_j\).
4.8 Restricciones de largo plazo
La identificación recursiva restringe el momento cero. Hay supuestos económicos que no tienen forma de restricción contemporánea pero sí de restricción sobre el efecto acumulado: la neutralidad del dinero en el largo plazo es el ejemplo canónico (Blanchard y Quah 1989; Galí 1999).
Si el VAR es estable, la suma de todas las respuestas de un choque converge. Sumando la Ecuación 4.4 sobre todos los horizontes,
\[ \Theta_{\infty} \;=\; \sum_{h=0}^{\infty} \Psi_h S \;=\; \big(I_n - \Phi_1 - \cdots - \Phi_p\big)^{-1} S \;=\; A^{-1} S , \tag{4.8}\]
donde \(A = I_n - \Phi_1 - \cdots - \Phi_p\) es conocida una vez estimada la dinámica. El elemento \((i,k)\) de \(\Theta_\infty\) es el efecto acumulado del choque \(k\) sobre la variable \(i\), y sobre él se imponen los ceros.
Proposición 4.3 · Identificación por restricciones de largo plazo Si \(\Theta_\infty = A^{-1} S\) es triangular inferior con diagonal positiva, entonces es el factor de Cholesky de
que es observable. La matriz de impacto queda identificada como \(S = A \cdot \operatorname{chol}(\Omega)\).
La matriz \(S\) que resulta no es triangular: los efectos contemporáneos quedan libres y las restricciones actúan sobre el acumulado. Ese es justamente el atractivo del esquema y también su costo, porque el efecto de largo plazo es la parte del modelo peor estimada.
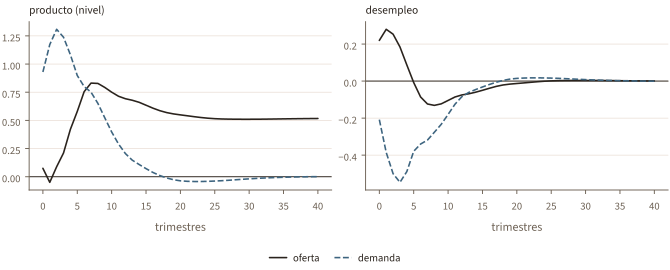
El ejercicio clásico es el de Blanchard y Quah (1989), y aquí se replica con su propia muestra: crecimiento trimestral del PBI y tasa de desempleo de Estados Unidos entre 1948T2 y 1987T4, ambos ya sin tendencia como en el artículo, con ocho rezagos. La única restricción es que el segundo choque no tenga efecto permanente sobre el nivel del producto. El primero queda sin restringir y se interpreta como choque de oferta; el segundo, como choque de demanda.
El cero de la columna de largo plazo es la restricción: el choque de demanda no deja efecto acumulado sobre el crecimiento, es decir, sobre el nivel del producto. La matriz de impacto, en cambio, no tiene ceros. Los signos son una normalización que la identificación no determina, porque \(\varepsilon\) y \(-\varepsilon\) son el mismo choque: se elige el choque de oferta que eleva el producto en el largo plazo y el de demanda que lo eleva al impacto. La segunda fila de la matriz de largo plazo no tiene lectura útil, porque suma respuestas de un nivel, el desempleo, y no de una tasa de crecimiento.
Hecho eso, el resto lo dicen los datos, y lo que dicen es el resultado que hizo famoso al artículo. El choque de demanda eleva el producto y baja el desempleo; el choque de oferta eleva el producto pero también el desempleo durante los primeros trimestres. Ese segundo hecho anticipa el debate posterior sobre tecnología y empleo, en el que Galí (1999) encontró que una mejora tecnológica reduce las horas trabajadas en el corto plazo.
Figura 4.5: Réplica de Blanchard y Quah (1989): respuesta acumulada del nivel del producto y respuesta del desempleo. El choque de demanda no tiene efecto permanente sobre el producto por construcción.
El panel izquierdo reproduce la forma de la figura del artículo. El choque de oferta lleva el nivel del producto a un máximo de 0.83 % a los 7 trimestres y lo deja permanentemente 0.52 puntos por encima; el de demanda produce una joroba de 1.31 % a los 2 trimestres, que se agota y vuelve a cero, como exige la restricción. El panel derecho muestra el resultado incómodo: tras un choque de oferta favorable el desempleo sube, hasta 0.28 puntos, y sólo cae por debajo de cero desde el trimestre 5.
La crítica seria a este esquema no es la aritmética sino la estadística: \(A^{-1}\) depende de la suma de todos los coeficientes, que en muestras cortas se estima con poca precisión, y pequeñas diferencias en esa suma mueven mucho la matriz de impacto. Faust y Leeper (1997) muestran que, sin supuestos adicionales sobre la dinámica, las restricciones de largo plazo pueden dar inferencia poco confiable aun con muestras grandes. Son las más exigentes con los datos de los tres esquemas de este capítulo.
4.9 Restricciones de signo
Los dos esquemas anteriores imponen ceros, que son afirmaciones fuertes. Las restricciones de signo imponen algo más débil y a menudo más creíble: la dirección del efecto (Faust 1998; Canova y De Nicoló 2002; Uhlig 2005). Volviendo al sistema de Stock y Watson (2001), un choque contractivo de política monetaria sube la tasa de fondos federales y baja la inflación; sobre el desempleo no se impone nada, porque es precisamente lo que se quiere averiguar. Es la estrategia agnóstica de Uhlig (2005), que en su artículo deja libre la respuesta del producto.
La mecánica se apoya en el resultado de la Proposición 4.1. Si \(P\) es el factor de Cholesky de \(\Sigma\) y \(Q\) es ortonormal, entonces
\[ \tilde{S} = P Q \quad\Longrightarrow\quad \tilde{S}\tilde{S}' = P Q Q' P' = P P' = \Sigma , \]
de modo que toda \(\tilde{S}\) así construida es un candidato válido. El conjunto de candidatos se recorre muestreando \(Q\) y quedándose con los que cumplen los signos.
Algoritmo 4.2: Identificación por restricciones de signo
Extraer una matriz ortonormal \(Q\) de dimensión \(n \times n\) de manera uniforme, por ejemplo con la descomposición QR de una matriz de normales estándar.
Formar el candidato \(\tilde{S} = P Q\) y calcular sus respuestas \(\Theta_h = \Psi_h \tilde{S}\) en los horizontes donde se imponen los signos.
Verificar el patrón de signos, permitiendo multiplicar una columna por \(-1\), porque \(\varepsilon\) y \(-\varepsilon\) son el mismo choque con el nombre cambiado. Si se cumple, guardar \(\tilde{S}\); si no, descartarla.
Repetir hasta reunir \(N\) matrices aceptadas y reportar el conjunto completo de respuestas.
signs = np.zeros((n, n))signs[0, 2] =-1# inflation fallssigns[2, 2] =+1# the rate risesaccepted = svar.sign_restricted_impacts( fit["Sigma"], fit["B"], n, p, signs, horizons=(0, 1), draws=1000, seed=5)set_irf = np.array([svar.responses(fit["B"], Si, n, p, 24)for Si in accepted])share =100* (set_irf[:, 8, 1, 2] >0).mean()print("matrices aceptadas:", len(accepted))print("desempleo en h=8: sube en %.0f%% de los modelos"% share)
matrices aceptadas: 1000
desempleo en h=8: sube en 46% de los modelos
median = np.median(set_irf, axis=0)q05 = np.quantile(set_irf, 0.05, axis=0)q95 = np.quantile(set_irf, 0.95, axis=0)size = figsize(0.40)fig, axes = plt.subplots(1, 3, figsize=size)steps = np.arange(set_irf.shape[1])for i, (ax, name) inenumerate(zip(axes, names)): ax.fill_between(steps, q05[:, i, 2], q95[:, i, 2], color=PALETTE["bands"][1], lw=0, alpha=0.5, label="conjunto (5 a 95 %)") ax.plot(steps, median[:, i, 2], lw=1.2, label="mediana", color=PALETTE["accent_dark"]) ax.plot(steps, theta_sd[:, i, 2], lw=1.0, ls=(0, (3, 2)), color=PALETTE["steel"], label="recursiva") charts.zero_line(ax) ax.set_title(name, fontsize=8.5) ax.set_xlabel("trimestres")charts.legend_outside(axes[1], ncol=3)plt.show()
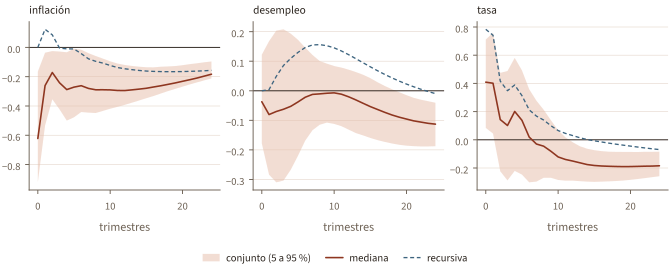
Figura 4.6: Respuestas al choque contractivo de política bajo restricciones de signo: mediana del conjunto identificado y rango del 5 al 95 %. La línea punteada es la respuesta recursiva. Las dos están en unidades de una desviación estándar del choque.
El resultado se parece al hallazgo de Uhlig (2005): una vez que se deja libre la respuesta de la variable real, el conjunto de modelos admisibles no se pone de acuerdo sobre su signo. A dos años, el 46 % de los modelos aceptados implica un aumento del desempleo, y el rango del 5 al 95 % va de −0.12 a 0.10 puntos. La respuesta recursiva, de 0.16 puntos para el mismo choque de una desviación estándar, queda fuera de ese rango, y no por azar: el modelo recursivo no pertenece al conjunto, porque deja la inflación en cero al impacto y la sube al trimestre siguiente, justo lo que las restricciones prohíben.
La figura tiene además tres rasgos raros para una política contractiva. Al impacto, la mediana de la inflación cae 0.62 puntos mientras la tasa sube apenas 0.41; la tasa queda por debajo de cero desde el trimestre 7; y la mediana del desempleo está por debajo de cero en todos los horizontes. No es un error de cálculo: cada matriz aceptada reproduce \(\hat{\Sigma}\) y cumple los signos, y un muestreo independiente sobre la esfera unitaria da los mismos cuantiles. Lo que explica la figura es qué hay dentro del conjunto. Como \(\tilde{S} = PQ\), la columna del choque de política es \(P\mathbf{q}\), con \(\mathbf{q}\) la tercera columna de \(Q\), de modo que el choque identificado es una combinación de los tres choques recursivos de la Sección 4.4 con pesos \(\mathbf{q}\), que cumplen \(\mathbf{q}'\mathbf{q} = 1\). La celda siguiente recupera esos pesos.
P = np.linalg.cholesky(fit["Sigma"])mix = np.array([np.linalg.solve(P, Si[:, 2])for Si in accepted]) # weights qquantiles = np.quantile(mix, [0.05, 0.5, 0.95], axis=0)pd.DataFrame(quantiles.round(2), columns=shocks, index=["5 %", "mediana", "95 %"])
inflación
desempleo
política
5 %
-0.94
-0.82
-0.11
mediana
-0.63
-0.21
0.60
95 %
-0.17
0.52
0.93
Como \(P\) es triangular, el impacto del choque sobre la inflación es \(p_{11} q_1\), y exigir que la inflación baje obliga a \(q_1 < 0\): todos los modelos del conjunto contienen un choque recursivo de inflación negativo. En la mediana pesa −0.63, contra 0.60 del choque recursivo de política, y en el 57 % de los modelos pesa más que este. En el 10 % el peso del choque recursivo de política es incluso negativo: el choque que el conjunto llama contractivo contiene allí una relajación recursiva, compensada por los otros dos componentes. Ese componente explica los tres rasgos: baja la inflación de inmediato y por mucho tiempo; baja la tasa, que en el sistema recursivo sube con la inflación en todos los horizontes; y baja el desempleo, que sube tras un choque de inflación. Lo que las restricciones identifican no es sólo política monetaria, sino también una caída de la inflación que no viene de la política y que cumple los mismos signos. Es el problema de los choques disfrazados de Wolf (2020), que con esta lógica reinterpreta el hallazgo de Uhlig (2005): parte de la ambigüedad sobre la actividad viene de la mezcla, no sólo de lo poco que se impuso. La salida es imponer más estructura, sea identificando también los otros choques o restringiendo la regla de política, como hacen Arias et al. (2019); el Ejercicio 4.10 prueba las dos.
Por la misma razón, la inflación sigue por debajo de cero mucho después de los dos trimestres restringidos: entre los trimestres 2 y 8 lo hace en al menos el 96 % de los modelos aceptados. Sería un error leer eso como evidencia de que la política baja la inflación. El conjunto se eligió entre modelos en que la inflación cae al principio, y el componente de inflación, muy persistente, prolonga la caída. Con restricciones de signo, lo que se concluye sobre las variables restringidas está en buena parte impuesto; lo informativo es lo que pasa con las libres, y aun eso depende de qué choques se cuelan en el conjunto.
Una advertencia de escala: el tamaño del choque no es comparable entre esquemas. Cada matriz aceptada implica un impacto distinto sobre la tasa, de modo que la figura usa desviaciones estándar y no puntos porcentuales. Lo que sí es comparable, y lo que importa, es el signo y la fracción del conjunto que lo sostiene.
Un conjunto de modelos no tiene mediana en ningún sentido útil. La mediana punto a punto de las respuestas aceptadas no corresponde en general a ninguna matriz de impacto del conjunto, así que reportarla como si fuera “el” resultado es un error frecuente (Fry y Pagan 2011). Además, muestrear \(Q\) uniformemente induce un prior sobre las respuestas que no es plano y que puede dominar al dato cuando las restricciones son pocas (Baumeister y Hamilton 2015). Lo honesto es reportar el rango y decir qué fracción del conjunto sostiene cada conclusión.
4.10 Proyecciones locales
Hay una manera distinta de estimar la misma respuesta: en lugar de iterar un modelo, correr una regresión por horizonte (Jordà 2005).
Definición 4.4 · Proyección local Dado un choque identificado \(\hat{\varepsilon}_{kt}\), la respuesta de la variable \(i\) en el horizonte \(h\) es el coeficiente \(\beta_{i,h}\) de
con \(\mathbf{w}_t\) un vector de controles, típicamente los rezagos del sistema. Se estima una regresión por cada horizonte y los errores estándar se corrigen por autocorrelación.
Las dos estrategias estiman el mismo objeto poblacional: en población y con rezagos suficientes, VAR y proyecciones locales dan la misma respuesta, y con \(p\) rezagos en ambos coinciden al menos hasta el horizonte \(p\)(Plagborg-Møller y Wolf 2021). Difieren en muestras finitas, y la diferencia es un intercambio conocido. El VAR impone la estructura dinámica en todos los horizontes, lo que lo hace eficiente si el modelo está bien especificado y sesgado si no lo está; la proyección local no extrapola, lo que la hace robusta a la mala especificación y bastante más ruidosa a horizontes largos.
policy = eps[:, 2] * S[2, 2] # in percentage pointsshock_series = np.r_[np.full(p, np.nan), policy]grid = np.arange(0, 17)lp = np.array([svar.local_projection(y, shock_series, h, lags=p)for h in grid], dtype=object)point = np.array([row[0][1] for row in lp])low = np.array([row[1][1] for row in lp])high = np.array([row[2][1] for row in lp])size = figsize(0.42)fig, ax = plt.subplots(figsize=size)ax.fill_between(grid, low, high, color=PALETTE["bands"][1], lw=0, alpha=0.5, label="IC 95 % (proyección local)")ax.plot(grid, point, lw=1.2, color=PALETTE["accent_dark"], label="proyección local")ax.plot(grid, theta[grid, 1, 2], lw=1.2, ls=(0, (4, 2)), color=PALETTE["ink"], label="VAR estructural")charts.zero_line(ax)ax.set_xlabel("trimestres")ax.set_ylabel("desempleo (%)")charts.legend_outside(ax, ncol=3)plt.show()
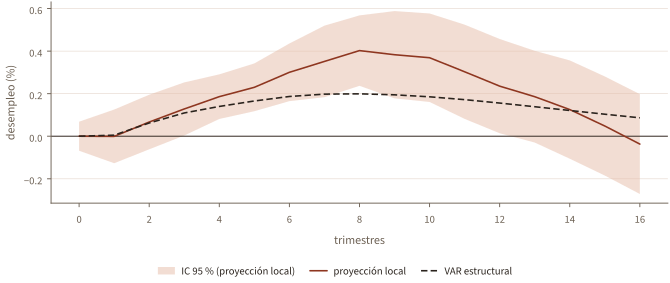
Figura 4.7: Respuesta del desempleo a un choque de política de un punto porcentual: VAR estructural y proyección local con intervalo al 95 %.
Las dos estimaciones coinciden en el signo y en el perfil: el desempleo sube a lo largo de los dos años siguientes al choque y después vuelve. En el trimestre del choque la respuesta es nula en ambas por construcción, porque el choque recursivo es ortogonal a la sorpresa de desempleo. Difieren en la magnitud del pico, que las dos alcanzan a los 8 trimestres y que la proyección local sitúa en 0.40 puntos frente a 0.20 del VAR, y en la suavidad, porque la forma companion obliga a la respuesta del VAR a decaer de manera regular mientras que la proyección local no impone nada entre horizontes. Cuál de las dos creer depende de qué se esté dispuesto a suponer: la proyección local no extrapola y paga el precio en varianza, el VAR extrapola y cobra el precio en sesgo si la estructura que impone es falsa. La banda de la proyección local, además, trata al choque como un dato, cuando es una estimación del VAR de la primera etapa; su ancho no incluye esa incertidumbre.
4.11 Otros esquemas y temas
Los tres esquemas anteriores cubren la mayor parte de la práctica, pero no agotan la literatura. Lo que sigue es un mapa mínimo, con la referencia donde estudiarlos.
Instrumentos externos
Si existe una variable observable correlacionada con el choque de interés y no con los demás, sirve de instrumento y evita restringir toda la matriz \(S\): basta con identificar una columna. Los ejemplos típicos son las sorpresas de alta frecuencia alrededor de los anuncios de política monetaria y las series narrativas de cambios impositivos (Mertens y Ravn 2013; Stock y Watson 2018; Gertler y Karadi 2015). Es el enfoque dominante hoy cuando hay un instrumento creíble disponible.
Restricciones de signo con ceros y restricciones narrativas
Se pueden combinar signos con ceros exactos (Arias et al. 2018) o exigir que los choques recuperados sean consistentes con episodios históricos conocidos, por ejemplo que el choque de política de un trimestre determinado haya sido contractivo (Antolín-Díaz y Rubio-Ramírez 2019). Ambas cosas reducen el conjunto identificado con información que el investigador tiene y el modelo no.
Identificación por heterocedasticidad
Si la varianza de los choques cambia entre regímenes conocidos y la matriz de impacto no, los distintos regímenes aportan ecuaciones adicionales y la identificación puede lograrse sin restricciones de signo ni de cero (Rigobon 2003). El supuesto que se paga es la estabilidad de \(S\) entre regímenes.
Invertibilidad
Todo lo anterior supone que los choques estructurales se pueden recuperar de los residuos del VAR, es decir, que la información del econometrista incluye la de los agentes. Cuando no es así, por ejemplo con noticias sobre el futuro que los agentes ven y el sistema no, ningún esquema de identificación recupera el choque verdadero. El problema se conoce como no invertibilidad o no fundamentalidad, y es una razón adicional para preferir instrumentos externos cuando existen (Ramey 2016).
Tamaño del sistema y frecuencia
La frecuencia de los datos cambia la credibilidad de los ceros contemporáneos en las dos direcciones que discutió la Sección 4.3: que la política no afecte a los precios dentro del período es más fácil de aceptar en un mes que en un trimestre, y que el banco central reaccione a datos del mismo período, al revés. Y los sistemas grandes, que permitirían incluir los controles que evitarían el price puzzle, chocan con el conteo de parámetros del Capítulo 3. Esa tensión es la que resuelve el Capítulo 5.
Ideas clave
Los datos determinan \(\Sigma\) y nada más: toda la variedad de matrices \(S\) con \(SS' = \Sigma\) ajusta igual de bien, así que la identificación es un supuesto económico que se declara, se defiende y se somete a sensibilidad.
Faltan exactamente \(n(n-1)/2\) restricciones. Los ceros contemporáneos las aportan con un orden y los ceros de largo plazo con la neutralidad de un choque. Los signos no las aportan: acotan el conjunto con la dirección de un efecto, y el resultado es un conjunto de modelos, no uno solo.
Las tres lecturas del SVAR (respuestas, varianza, historia) se construyen con las mismas matrices \(\Theta_j = \Psi_j S\) y responden preguntas distintas.
Las bandas bootstrap cubren la incertidumbre de estimación, no la de identificación. Las restricciones de signo hacen lo contrario: describen la incertidumbre de identificación con los parámetros fijos, y el conjunto que entregan puede mezclar el choque buscado con otros que cumplen los mismos signos.
Proyecciones locales y VAR estiman la misma respuesta poblacional; la elección entre ambos es un intercambio entre eficiencia y robustez a la mala especificación.
Lecturas recomendadas
Kilian y Lütkepohl (2017)
el tratamiento moderno y completo del análisis SVAR, con la inferencia hecha en serio.
Christiano, Eichenbaum y Evans (1999)
la referencia sobre choques de política monetaria identificados recursivamente y sobre el price puzzle.
Blanchard y Quah (1989)
el artículo que introdujo las restricciones de largo plazo.
Uhlig (2005)
el enfoque agnóstico y la incomodidad de sus resultados.
Ramey (2016)
el estado del arte sobre identificación de choques macroeconómicos, incluidos los instrumentos externos.
Plagborg-Møller y Wolf (2021)
proyecciones locales y VAR estiman la misma respuesta poblacional.
Wolf (2020)
por qué las restricciones de signo pueden confundir la política monetaria con otros choques.
Ejercicios
Ejercicio 4.1 En el sistema bivariado de la Sección 4.3, elija el número de rezagos con AIC, HQ y BIC, como en la Sección 3.10, y repita la Figura 4.1 con cada elección. ¿Sobrevive el price puzzle a todos los criterios? ¿Qué parte de la mejora de la Sección 4.5 se debe entonces a los rezagos y cuál al desempleo?
Ejercicio 4.2 Reestime el SVAR recursivo con los seis órdenes posibles de las tres variables y grafique las seis respuestas del desempleo al choque que eleva la tasa. ¿Qué conclusiones sobreviven a todos los órdenes y cuáles dependen de uno en particular?
Ejercicio 4.3 Verifique numéricamente la Proposición 4.1: genere cien matrices ortonormales \(Q\), calcule \(\tilde{S} = PQ\) en cada caso y confirme que \(\tilde{S}\tilde{S}'\) reproduce \(\hat{\Sigma}\) hasta el error de redondeo. Grafique las cien respuestas de la inflación al tercer choque.
Ejercicio 4.4 La banda bootstrap del Algoritmo 4.1 usa el diseño recursivo. Implemente el atajo de la Sección 4.5, que suma los residuos remuestreados a los valores ajustados y reestima con los rezagos de la serie artificial, y compare la persistencia de las respuestas medianas con la del diseño recursivo. ¿En qué dirección se sesga? Repita con el diseño fijo, que reutiliza los rezagos originales, y explique la diferencia.
Ejercicio 4.5 Agregue un índice de precios de materias primas al sistema, ordenado en primer lugar, y repita la identificación recursiva. Sirve el índice de precios al productor de todas las materias primas de FRED (PPIACO), descargado como en el Capítulo 1 y transformado en tasa de variación trimestral anualizada. ¿Desaparece el price puzzle? Discuta si el resultado justifica el supuesto de que ese índice no responde contemporáneamente a nada.
Ejercicio 4.6 Repita el capítulo con los datos peruanos del Ejercicio 3.7, agregando la actividad (columna gdp del mismo archivo) a la inflación y la tasa de referencia, entre 2003T4 y 2017T4 con dos rezagos. Compare la respuesta del producto al choque de política con la del desempleo estadounidense y discuta qué diferencias vienen de los datos y cuáles del tamaño de la muestra.
Ejercicio 4.7 En el ejercicio de restricciones de signo, agregue la exigencia de que el desempleo suba en los dos primeros trimestres. ¿Qué fracción de las matrices candidatas sobrevive ahora? Compare el conjunto resultante con la respuesta recursiva y explique por qué la comparación no es una prueba de nada.
Ejercicio 4.8 Calcule la descomposición histórica del desempleo y localice el trimestre en que el choque de política hizo su mayor aporte. ¿Coincide con la recesión de 1981-1982?
Ejercicio 4.9 Implemente el bootstrap con corrección de sesgo de Kilian (1998). Un primer bootstrap estima el sesgo de \(\hat{B}\) como la diferencia entre el promedio de las \(\hat{B}^{*}\) y \(\hat{B}\); se descuenta de \(\hat{B}\), reduciendo la corrección si el sistema corregido deja de ser estable, y el segundo bootstrap genera las muestras con la \(\hat{B}\) corregida y corrige cada \(\hat{B}^{*}\) de la misma manera. Compare la respuesta del desempleo al choque de política y su banda con las de la Figura 4.2. ¿Qué cambia más, el pico o la vuelta a cero?
Ejercicio 4.10 Repita la identificación por signos de la Sección 4.9 de dos maneras más exigentes. Primero, identifique también un choque de oferta (inflación y desempleo suben) y uno de demanda (inflación y tasa suben, desempleo baja) en los dos primeros trimestres. Segundo, en lugar de los signos de las respuestas, restrinja la regla de política como Arias et al. (2019): con \(A_0 = \tilde{S}^{-1}\), la fila del choque de política escribe \(R_t\) en función de \(\pi_t\) y \(u_t\); exija que la tasa suba con la inflación y baje con el desempleo. En cada caso, ¿cuánto pesa el choque recursivo de inflación en el choque identificado y qué fracción de los modelos implica un aumento del desempleo a dos años? ¿Alcanza alguna de las dos para que el conjunto deje de mezclar choques?
Antolín-Díaz, Juan, y Juan F. Rubio-Ramírez. 2019. «Narrative Sign Restrictions for SVARs». The American Economic Review 109 (7): 2802-29.
Arias, Jonas E., Dario Caldara, y Juan F. Rubio-Ramírez. 2019. «The Systematic Component of Monetary Policy in SVARs: An Agnostic Identification Procedure». Journal of Monetary Economics 101: 1-13.
Arias, Jonas E., Juan F. Rubio-Ramírez, y Daniel F. Waggoner. 2018. «Inference Based on Structural Vector Autoregressions Identified with Sign and Zero Restrictions: Theory and Applications». Econometrica 86 (2): 685-720.
Baumeister, Christiane, y James D. Hamilton. 2015. «Sign Restrictions, Structural Vector Autoregressions, and Useful Prior Information». Econometrica 83 (5): 1963-99.
Blanchard, Olivier Jean, y Danny Quah. 1989. «The Dynamic Effects of Aggregate Demand and Supply Disturbances». The American Economic Review 79 (4): 655-73.
Canova, Fabio, y Gianni De Nicoló. 2002. «Monetary Disturbances Matter for Business Fluctuations in the G-7». Journal of Monetary Economics 49 (6): 1131-59.
Christiano, Lawrence J., Martin Eichenbaum, y Charles L. Evans. 1999. «Monetary Policy Shocks: What Have We Learned and to What End?» En Handbook of Macroeconomics, editado por John B. Taylor y Michael Woodford, vol. 1. Elsevier.
Faust, Jon. 1998. «The Robustness of Identified VAR Conclusions about Money». Carnegie-Rochester Conference Series on Public Policy 49: 207-44.
Faust, Jon, y Eric M. Leeper. 1997. «When Do Long-Run Identifying Restrictions Give Reliable Results?»Journal of Business & Economic Statistics 15 (3): 345-53.
Fry, Renée, y Adrian Pagan. 2011. «Sign Restrictions in Structural Vector Autoregressions: A Critical Review». Journal of Economic Literature 49 (4): 938-60.
Galí, Jordi. 1999. «Technology, Employment, and the Business Cycle: Do Technology Shocks Explain Aggregate Fluctuations?»The American Economic Review 89 (1): 249-71.
Gertler, Mark, y Peter Karadi. 2015. «Monetary Policy Surprises, Credit Costs, and Economic Activity». American Economic Journal: Macroeconomics 7 (1): 44-76.
Gonçalves, Sílvia, y Lutz Kilian. 2004. «Bootstrapping Autoregressions with Conditional Heteroskedasticity of Unknown Form». Journal of Econometrics 123 (1): 89-120.
Jordà, Òscar. 2005. «Estimation and Inference of Impulse Responses by Local Projections». The American Economic Review 95 (1): 161-82.
Kilian, Lutz. 1998. «Small-Sample Confidence Intervals for Impulse Response Functions». The Review of Economics and Statistics 80 (2): 218-30.
Kilian, Lutz, y Helmut Lütkepohl. 2017. Structural Vector Autoregressive Analysis. Cambridge University Press.
Mertens, Karel, y Morten O. Ravn. 2013. «The Dynamic Effects of Personal and Corporate Income Tax Changes in the United States». The American Economic Review 103 (4): 1212-47.
Plagborg-Møller, Mikkel, y Christian K. Wolf. 2021. «Local Projections and VARs Estimate the Same Impulse Responses». Econometrica 89 (2): 955-80.
Ramey, Valerie A. 2016. «Macroeconomic Shocks and Their Propagation». En Handbook of Macroeconomics, editado por John B. Taylor y Harald Uhlig, vol. 2. Elsevier.
Rigobon, Roberto. 2003. «Identification through Heteroskedasticity». The Review of Economics and Statistics 85 (4): 777-92.
Sims, Christopher A. 1980. «Macroeconomics and Reality». Econometrica 48 (1): 1-48.
Sims, Christopher A. 1992. «Interpreting the Macroeconomic Time Series Facts: The Effects of Monetary Policy». European Economic Review 36 (5): 975-1000.
Stock, James H., y Mark W. Watson. 2001. «Vector Autoregressions». Journal of Economic Perspectives 15 (4): 101-15.
Stock, James H., y Mark W. Watson. 2018. «Identification and Estimation of Dynamic Causal Effects in Macroeconomics Using External Instruments». The Economic Journal 128 (610): 917-48.
Uhlig, Harald. 2005. «What Are the Effects of Monetary Policy on Output? Results from an Agnostic Identification Procedure». Journal of Monetary Economics 52 (2): 381-419.
Wolf, Christian K. 2020. «SVAR (Mis)identification and the Real Effects of Monetary Policy Shocks». American Economic Journal: Macroeconomics 12 (4): 1-32.