¿Cómo se estima un sistema que tiene más parámetros de los que la muestra puede fijar con precisión?
Ver el encogimiento como lo que es: un prior que promedia información previa con datos, ponderando por precisión.
Escribir el prior de Minnesota, muestrear la posterior con Gibbs y leer lo que el encogimiento le hace a los coeficientes.
Producir pronósticos por densidad y evaluarlos fuera de muestra contra mínimos cuadrados y contra la caminata aleatoria.
Requisitos previos.Capítulo 3 y Capítulo 4; distribución normal multivariada e inversa-Wishart; producto de Kronecker y el operador \(\operatorname{vec}\); el repaso bayesiano del Apéndice B.
El mismo sistema del Capítulo 4: inflación, desempleo y tasa de fondos federales de Estados Unidos, trimestrales de 1960Q1 a 2000Q4, cuatro rezagos, en data/processed/sw2001.csv. Mantener los datos fijos entre capítulos permite comparar lo que cambia por el método y no por la muestra.
5.1 Por qué encoger
El sistema de los dos capítulos anteriores tiene \(k = np + 1 = 13\) coeficientes por ecuación y \(39\) en total, contra \(160\) observaciones utilizables. No es un caso extremo, y aun así basta para que mínimos cuadrados pronostique peor que una regla trivial.
import numpy as npimport pandas as pdfrom macrobook import data_path, var, svar, bvarcsv = data_path("sw2001.csv")data = pd.read_csv(csv, index_col="date")data.index = pd.PeriodIndex(data.index, freq="Q")order = ["infl", "unemp", "ff"]sample = data[order]dates = sample.index.to_timestamp(how="end")y = sample.to_numpy()n, p =len(order), 4k = n * p +1print("coeficientes por ecuación:", k)print("coeficientes del sistema:", n * k)print("observaciones utilizables:", len(y) - p)
coeficientes por ecuación: 13
coeficientes del sistema: 39
observaciones utilizables: 160
El cuadro compara la raíz del error cuadrático medio de un VAR estimado por mínimos cuadrados con la de una caminata aleatoria, en 97 ventanas que empiezan en 1975 y se extienden un trimestre cada vez. Un número mayor que uno significa que el VAR pierde. Pierde en casi todas las casillas, y pierde más cuanto más largo el horizonte. El modelo con más información es el que pronostica peor, porque estima demasiadas cosas con demasiado poco.
La salida no es dejar de modelar sino restringir. El enfoque bayesiano escribe la restricción como una distribución a priori: en lugar de fijar coeficientes en cero, los concentra alrededor de un valor con una dispersión que el investigador elige. El resultado es un estimador sesgado y mucho más preciso, que es un buen negocio cuando la varianza es el problema (Litterman 1986; Bańbura et al. 2010).
5.2 Prior, verosimilitud y posterior
El teorema de Bayes dice que la información se combina multiplicando:
Con distribuciones normales esa multiplicación tiene una forma reconocible. Si el prior de un escalar es \(\theta \sim N(\theta_0, \tau^2)\) y la muestra aporta \(\hat{\theta} \sim N(\theta, s^2)\), la posterior es normal con media
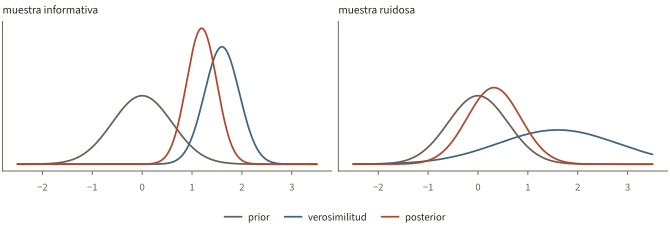
La media posterior es un promedio ponderado por precisión, es decir por el inverso de la varianza. Nadie fija ese peso a mano: si la muestra es informativa, \(s^{-2}\) es grande y la posterior se pega al dato; si es ruidosa, manda el prior. Y un prior difuso, \(\tau^2 \to \infty\), devuelve exactamente el estimador clásico.
Figura 5.1: El mismo prior con dos muestras. A la izquierda la verosimilitud es angosta y la posterior se pega a ella; a la derecha es ancha y la posterior se queda cerca del prior.
El encogimiento no es un truco de estimación: es la respuesta correcta cuando se tiene información previa y datos, y ninguno de los dos es perfecto. La discusión no es si usar información previa, porque elegir las variables y los rezagos ya lo es, sino si escribirla de manera explícita y auditable.
5.3 La forma vectorizada
El prior no se escribe sobre la matriz \(B\) sino sobre el vector de todos sus coeficientes, así que conviene apilar también las ecuaciones. Escribimos en minúsculas los objetos vectorizados,
\[
y = \operatorname{vec}(Y) \ (nT \times 1), \qquad
b = \operatorname{vec}(B) \ (nk \times 1), \qquad
u = \operatorname{vec}(U) \ (nT \times 1),
\]
donde \(\operatorname{vec}\) apila las columnas, es decir primero la ecuación 1 y después la 2. Aplicando \(\operatorname{vec}\) a \(Y = XB + U\) y usando \(\operatorname{vec}(XB) = (I_n \otimes X)\operatorname{vec}(B)\),
\[
y = (I_n \otimes X)\, b + u,
\qquad \mathbb{E}[u u'] = \Sigma \otimes I_T .
\tag{5.3}\]
Con dos variables, \(T\) observaciones y \(k = np + 1\) coeficientes por ecuación, la Ecuación 5.3 se ve así:
que dice dos cosas a la vez: dentro de cada ecuación los errores no están correlacionados en el tiempo, y entre ecuaciones sí lo están en el mismo periodo.
Sobre este vector \(b\) actúa todo lo que viene: el prior le pone una normal con media \(b_0\) y varianza \(H\), y la posterior de la Sección 5.5 es una normal en ese mismo espacio.
5.4 El prior de Minnesota
Hace falta elegir \(b_0\) y \(H\), es decir escribir qué se cree antes de mirar los datos. La propuesta que se impuso (Litterman 1986) parte de una observación simple: una serie macroeconómica se parece mucho más a su propio pasado que a un sistema donde todas las variables importan con todos sus rezagos.
Definición 5.1 · Prior de Minnesota La media a priori del coeficiente del primer rezago propio de la variable \(i\) es \(\delta_i\), y la de todos los demás coeficientes de rezago es cero. La varianza a priori del coeficiente del rezago \(\ell\) de la variable \(j\) en la ecuación \(i\) es
\[
\operatorname{Var}\big[(\Phi_\ell)_{ij}\big] =
\begin{cases}
\left(\dfrac{\lambda_1}{\ell^{\lambda_3}}\right)^{2}, & i = j, \\[2.2ex]
\left(\dfrac{\lambda_1 \lambda_2\, \sigma_i}{\ell^{\lambda_3}\, \sigma_j}\right)^{2}, & i \neq j,
\end{cases}
\tag{5.6}\]
donde \(\sigma_i\) es la desviación estándar del residuo de una regresión AR(\(p\)) univariada de la variable \(i\). La constante recibe una varianza difusa, \((\sigma_i \lambda_4)^2\) con \(\lambda_4\) grande.
Los cuatro hiperparámetros tienen lectura directa. \(\lambda_1\) fija la intensidad general del encogimiento: con \(\lambda_1 \to 0\) el prior manda y el sistema se vuelve \(n\) caminatas aleatorias independientes; con \(\lambda_1 \to \infty\) el prior desaparece y queda mínimos cuadrados. \(\lambda_2 \leq 1\) castiga más a los rezagos de las otras variables que a los propios. \(\lambda_3\) apaga los rezagos lejanos. El cociente \(\sigma_i/\sigma_j\) sólo corrige unidades entre ecuaciones.
\(\delta_i = 1\) dice que la mejor descripción a priori de la serie es una caminata aleatoria, y es razonable para variables muy persistentes como las tres de este capítulo. Con tasas de crecimiento, que revierten rápido, corresponde \(\delta_i = 0\) o un valor intermedio: fijar \(\delta_i = 1\) impone una persistencia que la serie no tiene y arrastra los pronósticos de largo plazo.
La última línea imprime la desviación estándar a priori de los primeros coeficientes de la ecuación de la tasa: enorme para la constante, 0.2 para su propio primer rezago y alrededor de 0.1 para los rezagos de las otras variables. El prior no decreta que un coeficiente sea cero: dice que, a falta de evidencia en contra, se parecerá a cero.
5.5 De la prior a la posterior
Falta un prior para \(\Sigma\). La elección natural es una inversa-Wishart, \(\Sigma \sim \mathcal{IW}(S_0, \nu_0)\), que es la familia conjugada para una covarianza. Con un prior normal para \(b\)independiente del de \(\Sigma\), la posterior conjunta no tiene forma cerrada, pero las dos condicionales sí, y eso basta para muestrear.
Algoritmo 5.1: Muestreador de Gibbs para el prior normal e inversa-Wishart independiente
Empezar con \(\Sigma^{(0)} = \hat{\Sigma}_{\text{MCO}}\).
Repetir \(M\) veces, descartar las primeras extracciones (el burn-in) y quedarse con el resto.
El paso 2 es la Ecuación 5.2 escrita con matrices: \(H^{-1}\) es la precisión del prior, \(\Sigma^{-1} \otimes X'X\) la del dato, y la media posterior es el promedio de ambas fuentes ponderado por esas precisiones. El paso 3 suma a la escala del prior la suma de cuadrados de los residuos del sorteo anterior. Ninguno de los dos pasos requiere aproximación: ambas condicionales se muestrean de forma exacta.
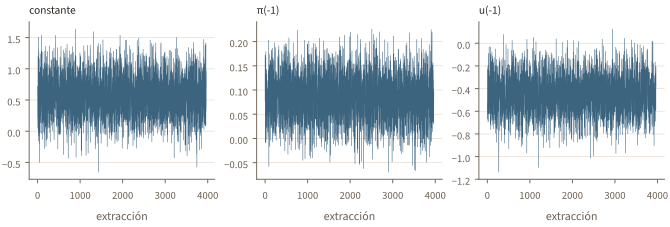
El descarte de las extracciones explosivas merece un comentario. Cada sorteo de \(b\) define un sistema que puede ser estable o no; los inestables no tienen media incondicional ni impulso-respuesta que converja, así que se descartan. La práctica es estándar y equivale a un prior que pone probabilidad cero a la región explosiva (Blake y Mumtaz 2017).
Figura 5.2: Trazas de tres coeficientes de la ecuación de la tasa. La cadena se mueve alrededor de un nivel estable, que es lo que se espera después del burn-in.
5.6 Qué hace el encogimiento
La comparación que importa es entre la media posterior y mínimos cuadrados.
B_post = draws_b.mean(axis=0).reshape((k, n), order="F")fit = var.ols(y, p)rows = ["constante"] + [f"{v}(-{lag})"for lag inrange(1, p +1)for v in ["π", "u", "R"]]comparison = pd.DataFrame( {"MCO": fit["B"][:, 2], "posterior": B_post[:, 2]}, index=rows).round(3)comparison.head(7)
MCO
posterior
constante
0.541
0.570
π(-1)
0.068
0.085
u(-1)
-1.643
-0.455
R(-1)
0.946
0.937
π(-2)
0.226
0.046
u(-2)
1.824
0.166
R(-2)
-0.367
-0.124
En la ecuación de la tasa de fondos federales, mínimos cuadrados le asigna al primer rezago del desempleo un coeficiente de \(-1.64\), que en una regresión con trece coeficientes y ciento sesenta observaciones es en buena parte ruido. La posterior lo lleva a \(-0.45\). El primer rezago propio de la tasa, en cambio, casi no se mueve: pasa de 0.95 a 0.94, porque ahí los datos son informativos y el prior no tiene nada que corregir. Eso es exactamente lo que debe hacer un prior bien puesto: encoger donde no hay información y apartarse donde la hay.
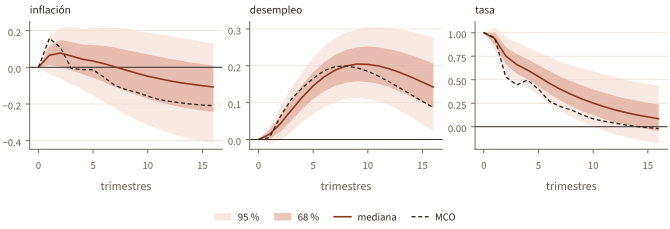
El encogimiento también se ve en las respuestas al impulso. Con las mismas extracciones de la posterior y la identificación recursiva del Sección 4.3, las bandas ya no son bootstrap sino cuantiles de la distribución posterior.
Figura 5.3: Respuesta a un choque de política de un punto porcentual: mediana posterior con bandas al 68 % y 95 %, y la respuesta por mínimos cuadrados.
La mediana posterior de la respuesta del desempleo alcanza 0.20 puntos a los dos años, prácticamente la misma cifra que mínimos cuadrados, con un intervalo al 68 % de 0.15 a 0.24 y uno al 95 % de 0.11 a 0.29. El encogimiento no movió el resultado central, y eso es informativo: donde los datos hablan, el prior no estorba. Lo que sí cambia es el resto del recorrido, que la posterior devuelve a cero de manera más suave, y el ancho de las bandas, más angostas que las bootstrap del Sección 4.5 porque el prior aporta información propia.
Una banda posterior no es un intervalo de confianza. Dice que, dados el modelo, el prior y los datos, el parámetro está en ese rango con probabilidad 0.68 o 0.95. Es una afirmación más fuerte que la frecuentista y depende del prior: si el prior es informativo y equivocado, la banda será angosta y estará en el lugar equivocado. Por eso se reporta siempre qué prior se usó y se muestra la sensibilidad a sus hiperparámetros.
5.7 Pronóstico por densidad
El pronóstico bayesiano no es un número con una banda pegada después: es una distribución, la densidad predictiva, que se obtiene simulando hacia adelante con cada extracción de la posterior y con choques nuevos en cada trimestre.
Algoritmo 5.2: Densidad predictiva de un VAR bayesiano
Para cada extracción \((b^{(m)}, \Sigma^{(m)})\) de la posterior:
Poner las últimas \(p\) observaciones como estado inicial.
Para \(j = 1, \ldots, h\), extraer \(\mathbf{u}^{(m)}_{T+j} \sim N(0, \Sigma^{(m)})\) e iterar el VAR con los coeficientes \(b^{(m)}\).
Al final se tienen \(M\) trayectorias completas. Los percentiles de esas trayectorias en cada horizonte son las bandas del pronóstico.
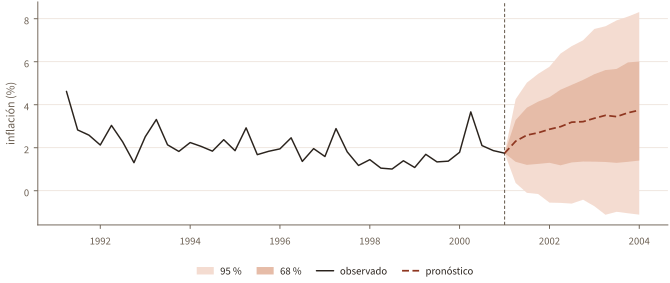
La diferencia con el intervalo del Sección 3.9 es que aquí la incertidumbre de los parámetros está dentro: cada trayectoria usa un modelo distinto, extraído de la posterior. El intervalo frecuentista trataba \(\hat{B}\) y \(\hat{\Sigma}\) como los valores verdaderos, y por eso subestimaba la incertidumbre.
Figura 5.4: Densidad predictiva de la inflación a doce trimestres. Bandas al 68 % y 95 % de la distribución predictiva, que incorpora la incertidumbre sobre los parámetros.
La mediana sube de 1.7 % a cerca de 3.5 % en tres años. No es una predicción del modelo sobre la economía de 2001: es el resultado de que, con \(\delta_i = 1\) y una muestra cuya inflación media es 3.9 %, la posterior sigue creyendo en un proceso persistente que vuelve despacio hacia la media histórica. Cambiar el prior cambia esa senda, y la sección siguiente muestra cuánto.
5.8 Elegir los hiperparámetros
Queda la pregunta incómoda: de dónde sale \(\lambda_1 = 0.2\). Hay tres respuestas en uso, y conviene conocer las tres.
La primera es la tradición: Litterman probó valores en los años ochenta, funcionaron, y quedaron. La segunda es la evaluación fuera de muestra: elegir el valor que mejor pronostica en una parte de la muestra reservada para eso. La tercera, hoy la más defendible, es tratar los hiperparámetros como parámetros y ponerles su propio prior, de modo que los datos ayuden a elegirlos maximizando la verosimilitud marginal (Giannone et al. 2015).
La segunda es fácil de mostrar y explica la lógica de las otras dos.
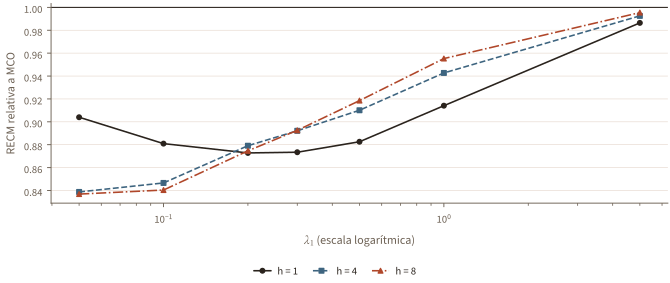
lambdas = [0.05, 0.1, 0.2, 0.3, 0.5, 1.0, 5.0]errors_lam = {value: [] for value in lambdas}for t inrange(start, len(y) - horizon +1): train, actual = y[:t], y[t:t + horizon]for value in lambdas: prior = bvar.minnesota_prior( train, p, lam=(value, 0.5, 1.0, 1e5), delta=1.0) path = bvar.posterior_mean_forecast( train, p, prior[0], prior[1], horizon) errors_lam[value].append(actual - path)relative = {value: (np.sqrt((np.array(err) **2).mean(axis=0))/ rmse["MCO"]).mean(axis=1)for value, err in errors_lam.items()}size = figsize(0.42)fig, ax = plt.subplots(figsize=size)for j, step inenumerate([0, 3, 7]): ax.plot(lambdas, [relative[v][step] for v in lambdas], lw=1.2, marker=PALETTE["shock_marker"][j], ms=3.5, color=PALETTE["shocks"][j], ls=PALETTE["shock_linestyle"][j], label=f"h = {step +1}")ax.axhline(1.0, color=PALETTE["ink"], lw=0.8)ax.set_xscale("log")ax.set_xlabel("$\\lambda_1$ (escala logarítmica)")ax.set_ylabel("RECM relativa a MCO")charts.legend_outside(ax, ncol=3)plt.show()
Figura 5.5: Error de pronóstico fuera de muestra según la intensidad del encogimiento, relativo a mínimos cuadrados. Cada línea es un horizonte; el promedio es sobre las tres variables y 97 ventanas.
La curva cuenta toda la historia del capítulo. Con \(\lambda_1 = 5\) el prior es irrelevante y el BVAR pronostica como mínimos cuadrados, que es el punto de la derecha pegado a uno. A medida que el prior se ajusta, el error cae hasta un 12 o 16 % por debajo de mínimos cuadrados. A un trimestre el mínimo está alrededor de \(\lambda_1 = 0.2\) y a horizontes largos el error sigue bajando con priors más ajustados, porque a esa distancia el mejor pronóstico se parece cada vez más a la caminata aleatoria que el prior describe.
Elegir \(\lambda_1\) mirando el error de pronóstico de toda la muestra y reportar después ese mismo error como evidencia del método es hacer trampa dos veces con los mismos datos. Si los hiperparámetros se eligen fuera de muestra, la evaluación debe hacerse sobre un tramo que no se usó para elegirlos, o con una ventana móvil que reelija en cada paso con la información disponible hasta ese momento.
5.9 Otros temas
Priors conjugados y observaciones ficticias
Si el prior de \(b\) se escribe con la misma \(\Sigma\) que la verosimilitud, es decir \(b \mid \Sigma \sim N(b_0, \Sigma \otimes \Omega_0)\), el par normal-Wishart es conjugado y la posterior tiene forma cerrada: no hace falta Gibbs y todo se calcula con una regresión aumentada. El truco práctico es escribir el prior como observaciones ficticias que se apilan debajo de los datos (Bańbura et al. 2010). La misma técnica permite añadir priors de suma de coeficientes y de cointegración ficticia, que disciplinan el comportamiento de largo plazo del sistema.
VAR grandes
Con veinte o cien variables el conteo de parámetros se vuelve absurdo y el encogimiento pasa de conveniente a indispensable. La receta es escalar la intensidad del prior con el tamaño del sistema, de modo que el ajuste dentro de muestra se mantenga constante al agregar variables (Bańbura et al. 2010; Giannone et al. 2015). Un BVAR grande bien encogido pronostica tan bien como los factores dinámicos y permite mirar todas las variables a la vez.
Análisis estructural bayesiano
Todo el Capítulo 4 se traslada sin cambios: para cada extracción de la posterior se identifica y se calcula la respuesta, y el resultado es una distribución posterior de respuestas en lugar de una banda bootstrap. Con restricciones de signo, la combinación es natural, porque el muestreo de \(Q\) y el de la posterior se hacen en el mismo bucle (Uhlig 2005; Arias et al. 2018).
Datos atípicos y la pandemia
Los modelos lineales con errores gaussianos tratan una caída de treinta puntos como evidencia sobre la dinámica normal del sistema, y por eso 2020 rompió la mayoría de los VAR estimados hasta entonces. Las soluciones van desde variables de volatilidad estocástica hasta el tratamiento explícito de los trimestres de pandemia como atípicos (Lenza y Primiceri 2022), y el Capítulo 9 retoma el punto.
Ideas clave
El problema del VAR sin restricciones no es el sesgo sino la varianza: con pocos datos por parámetro, mínimos cuadrados pronostica peor que una caminata aleatoria.
La posterior es un promedio ponderado por precisión entre prior y datos. Con prior difuso reproduce mínimos cuadrados, así que el enfoque clásico es un caso particular.
El prior de Minnesota escribe una idea económica concreta, que cada serie se parece a su propio pasado, con cuatro hiperparámetros de lectura clara.
El muestreador de Gibbs alterna dos condicionales exactas; el precio de la flexibilidad es simulación en lugar de fórmulas.
El pronóstico bayesiano es una densidad que incorpora la incertidumbre de los parámetros, y su ventaja sobre mínimos cuadrados se verifica fuera de muestra.
Lecturas recomendadas
Blake y Mumtaz (2017)
el manual del CCBS con los algoritmos escritos paso a paso; la referencia más cercana al espíritu de este capítulo.
Litterman (1986)
el registro original de cinco años pronosticando con un VAR bayesiano, y el origen del nombre del prior.
Bańbura, Giannone y Reichlin (2010)
cómo escalar el encogimiento con el tamaño del sistema.
Giannone, Lenza y Primiceri (2015)
los hiperparámetros como parámetros: prior jerárquico y verosimilitud marginal.
Karlsson (2013)
la revisión enciclopédica de priors y algoritmos para VAR bayesianos.
Ejercicios
Ejercicio 5.1 Muestre que, cuando todas las ecuaciones comparten los mismos regresores, mínimos cuadrados ecuación por ecuación coincide con mínimos cuadrados generalizados sobre el sistema apilado.
Ver solución
Apilando por columnas, \(\operatorname{vec}(Y) = (I_n \otimes X)\operatorname{vec}(B) + \operatorname{vec}(U)\) con \(\operatorname{Var}[\operatorname{vec}(U)] = \Sigma \otimes I_T\). El estimador de MCG es \[
\hat{b}_{MCG} = \big[(I_n \otimes X)'(\Sigma^{-1} \otimes I_T)(I_n \otimes X)\big]^{-1}(I_n \otimes X)'(\Sigma^{-1} \otimes I_T)\operatorname{vec}(Y).
\] Usando \((A \otimes B)(C \otimes D) = AC \otimes BD\), el primer factor es \(\Sigma^{-1} \otimes X'X\) y el segundo \((\Sigma^{-1} \otimes X')\operatorname{vec}(Y)\). Entonces \[
\hat{b}_{MCG} = (\Sigma \otimes (X'X)^{-1})(\Sigma^{-1} \otimes X')\operatorname{vec}(Y)
= (I_n \otimes (X'X)^{-1}X')\operatorname{vec}(Y),
\] que es exactamente \(\operatorname{vec}\big((X'X)^{-1}X'Y\big)\): MCO ecuación por ecuación. \(\Sigma\) desaparece.
Ejercicio 5.2 Verifique numéricamente que un prior difuso devuelve mínimos cuadrados: multiplique \(H\) por \(10^6\), vuelva a muestrear y compare la media posterior con \(\hat{B}\). ¿Cuánto hay que aflojar el prior para que la diferencia baje del uno por ciento?
Ejercicio 5.3 Repita el Algoritmo 5.1 con \(\delta_i = 0\) en lugar de \(\delta_i = 1\) y compare la densidad predictiva de la inflación. ¿Hacia dónde revierte cada una y por qué?
Ejercicio 5.4 Estudie la convergencia de la cadena: grafique la media acumulada de tres coeficientes y calcule el tamaño de muestra efectivo con la autocorrelación de las extracciones. ¿Cuántas extracciones hacen falta para estabilizar la segunda cifra decimal?
Ejercicio 5.5 Añada al sistema el crecimiento del PBI real y el agregado monetario M2, de modo que \(n = 5\) y el sistema tenga 105 coeficientes. Compare la RECM fuera de muestra de mínimos cuadrados y del BVAR. ¿Crece la ventaja del encogimiento con el tamaño del sistema?
Ejercicio 5.6 Implemente el prior conjugado con observaciones ficticias: apile bajo \(Y\) y \(X\) las filas que reproducen la media y la varianza de la Definición 5.1, estime por mínimos cuadrados sobre la muestra aumentada y compare con la media posterior del muestreador de Gibbs.
Arias, Jonas E., Juan F. Rubio-Ramírez, y Daniel F. Waggoner. 2018. «Inference Based on Structural Vector Autoregressions Identified with Sign and Zero Restrictions: Theory and Applications». Econometrica 86 (2): 685-720.
Bańbura, Marta, Domenico Giannone, y Lucrezia Reichlin. 2010. «Large Bayesian Vector Auto Regressions». Journal of Applied Econometrics 25 (1): 71-92.
Blake, Andrew P., y Haroon Mumtaz. 2017. Applied Bayesian Econometrics for Central Bankers. Technical Handbook. Centre for Central Banking Studies, Bank of England.
Giannone, Domenico, Michele Lenza, y Giorgio E. Primiceri. 2015. «Prior Selection for Vector Autoregressions». The Review of Economics and Statistics 97 (2): 436-51.
Lenza, Michele, y Giorgio E. Primiceri. 2022. «How to Estimate a Vector Autoregression after March 2020». Journal of Applied Econometrics 37 (4): 688-99.
Litterman, Robert B. 1986. «Forecasting with Bayesian Vector Autoregressions: Five Years of Experience». Journal of Business & Economic Statistics 4 (1): 25-38.
Uhlig, Harald. 2005. «What Are the Effects of Monetary Policy on Output? Results from an Agnostic Identification Procedure». Journal of Monetary Economics 52 (2): 381-419.