import numpy as np
import pandas as pd

from macrobook import data_path


def read(name, freq):
    table = pd.read_csv(data_path(name), index_col="date")
    table.index = pd.PeriodIndex(table.index, freq=freq)
    return table


daily = read("us_daily.csv", "D")
monthly = read("us_monthly.csv", "M")["2000":]
quarterly = read("us_quarterly.csv", "Q")

fx = daily["usd_eur"]["2000":].dropna()   # sin feriados
unemployment = monthly["unemployment_nsa"]
fed_funds = monthly["fed_funds"]
gdp_us = quarterly["gdp"]["2000":]        # desestacionalizado
gdp_us_nsa = quarterly["gdp_nsa"].dropna()  # desde 2002
gdp_pe = read("peru_quarterly.csv", "Q")["gdp_nsa"]1 Datos macroeconómicos
El desempleo de Estados Unidos sube en promedio siete décimas cada enero, sin que la economía empeore. Cuando una serie macroeconómica sube o baja, ¿qué parte del movimiento es un cambio en la economía y qué parte es tendencia, calendario o la forma en que se mide?
- Reconocer las formas que toma una serie macroeconómica (frecuencia, tendencia, ciclo, estacionalidad, quiebres) y resumirlas en unos pocos hechos estilizados.
- Descomponer una serie en tendencia, ciclo, estacionalidad e irregular, y saber qué parte de esa separación es un supuesto.
- Entender qué hace un ajuste estacional, cómo leer una serie desestacionalizada y por qué la variación interanual no la reemplaza.
- Elegir la transformación con un criterio, y explicar por qué los economistas trabajan casi siempre en logaritmos.
Requisitos previos. Nociones de series de tiempo; pandas, fechas y gráficos (secciones 0.7 y 0.8).
| Serie | Fuente | Frecuencia | Código |
|---|---|---|---|
| Tipo de cambio, dólares por euro | FRED | diaria | DEXUSEU |
| Tasa de desempleo de EE.UU. (sin desestacionalizar) | FRED | mensual | UNRATENSA |
| Tasa efectiva de fondos federales | FRED | mensual | FEDFUNDS |
| PBI real de EE.UU. (desestacionalizado) | FRED | trimestral | GDPC1 |
| PBI real de EE.UU. (sin desestacionalizar) | FRED | trimestral | ND000334Q |
| PBI real del Perú (sin desestacionalizar) | BCRP | trimestral | PN02538AQ |
Los ejercicios usan además dos series mensuales del BCRP: el PBI desestacionalizado (PN01773AM) y el IPC de Lima (PN38705PM). Los archivos crudos están en data/raw/ y los CSV que leen los capítulos los construyen code/python/build_us_data.py y code/python/build_peru_data.py.
1.1 Cómo se ve una serie macroeconómica
Antes de modelar una serie conviene mirarla. La Figura 1.1 reúne cuatro series de Estados Unidos elegidas porque no se parecen entre sí: cada una muestra una forma distinta en que llega un dato macroeconómico, y buena parte de lo que el libro hace después es una respuesta a alguna de ellas.
import matplotlib.pyplot as plt

from macrobook import use_style, figsize, PALETTE, charts

use_style()

panels = [(fx, "dólares por euro, diario"),
          (unemployment, "desempleo (%), mensual"),
          (fed_funds, "fondos federales (%), mensual"),
          (gdp_us / 1000, "PBI real (billones), trimestral")]
start = pd.Timestamp("2000-01-01")
end = pd.Timestamp("2026-12-31")

fig, axes = plt.subplots(2, 2, figsize=figsize(0.62))
for ax, (series, title) in zip(axes.ravel(), panels):
    dates = series.index.to_timestamp(how="end")
    ax.plot(dates, series, color=PALETTE["ink"], lw=0.8)
    ax.set_xlim(start, end)
    charts.year_ticks(ax, every=5)
    ax.set_title(title, fontsize=8.5)
fig.tight_layout()
plt.show()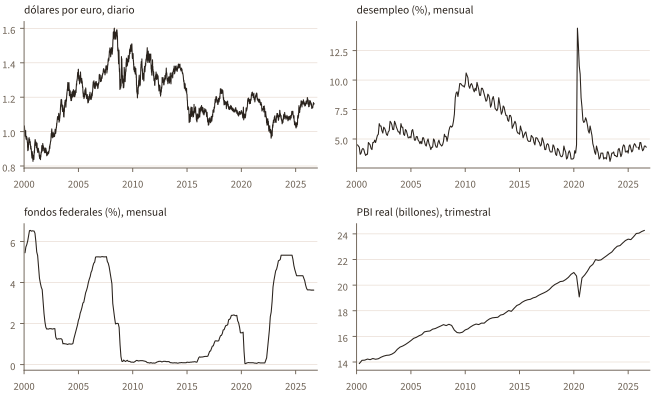
Las cuatro difieren en casi todo. Difieren en la frecuencia: los precios de mercado se observan todos los días, el desempleo cada mes y las cuentas nacionales cada trimestre, con semanas de rezago. Difieren en la tendencia: el PBI crece de manera sostenida, mientras que el tipo de cambio, el desempleo y la tasa de interés vuelven una y otra vez a los mismos niveles. Y difieren en lo que pasa en el corto plazo: el desempleo sin ajustar sube y baja con el calendario; la tasa de fondos federales es una variable de política que cambia por decisiones discretas; el tipo de cambio es un precio financiero que se mueve todos los días. El PBI de la figura ya viene desestacionalizado por la oficina de estadística; la versión sin ajustar, que la BEA publica recién desde 2002, aparece en la Sección 1.3.
Hechos estilizados
Cuatro rasgos de la Figura 1.1 reaparecen en todo el libro.
Los niveles son muy persistentes; los cambios, mucho menos. La autocorrelación de primer orden del nivel es de al menos 0.94 en las cuatro series: el valor de hoy es casi el de ayer. La de los cambios cuenta otra historia en cada serie. Es 0.01 en el tipo de cambio, cuya variación diaria es casi impredecible, y 0.71 en la tasa de fondos federales, que la Reserva Federal mueve de a poco y en la misma dirección varios meses seguidos. Que los niveles se parezcan a una caminata aleatoria es la razón de que el Capítulo 2 discuta raíces unitarias y de que casi todos los modelos se estimen sobre cambios.
Sin ajustar, el calendario domina el corto plazo. Dejando fuera 2020 y 2021, el desempleo sube en promedio 0.7 puntos en enero, cuando terminan los contratos de fin de año, y 0.4 en junio, cuando los estudiantes salen a buscar trabajo, y baja 0.5 en abril. Las medias por mes explican 78 % de la varianza de su variación mensual. Separar esa parte es el tema de la Sección 1.3.
Las series se mueven juntas a lo largo del ciclo. El desempleo pasa de 4.3 % en 2007 a 10.6 % tras la crisis financiera, y de 4.5 % a 14.4 % entre marzo y abril de 2020; en los mismos episodios el PBI cae 4.0 % y 9.1 %, y la Reserva Federal lleva la tasa a su piso. La correlación entre las variaciones a doce meses del desempleo y de la tasa es −0.45. Entre tanto el PBI crece 2.2 % por año en promedio. Ninguna serie se entiende sola, y esa es la motivación del VAR del Capítulo 3.
La volatilidad cambia y hay pisos. La volatilidad anualizada del tipo de cambio va de 4.7 % en 2019 a 14.2 % en 2008, y un modelo con varianza constante describe mal ambos años (Capítulo 9). La tasa de fondos federales pasó 109 de los 320 meses desde 2000 en 0.25 % o menos, un piso que ningún modelo lineal respeta. Y un episodio como la pandemia domina cualquier estimación si no se trata explícitamente (Sección 1.6).
1.2 La descomposición de una serie
La Figura 1.1 invita a mirar cada serie como la suma de piezas con interpretación distinta: una tendencia, un ciclo, un patrón que se repite cada año y un ruido. Esa es la tradición que arranca con Burns y Mitchell (1946).
Definición 1.1 · Descomposición por componentes no observados En logaritmos, una serie se escribe como
\[ \ln y_t = \tau_t + c_t + s_t + \eta_t , \tag{1.1}\]
donde \(\tau_t\) es la tendencia, \(c_t\) el ciclo, \(s_t\) el componente estacional y \(\eta_t\) el irregular. En niveles, la misma relación es multiplicativa: \(y_t = T_t \cdot C_t \cdot S_t \cdot I_t\).
Trabajar en logaritmos convierte la descomposición multiplicativa en aditiva, y esa es la primera razón práctica por la que los economistas usan logaritmos: la amplitud de la estacionalidad de una serie que crece suele ser proporcional al nivel, no fija en unidades.
La Ecuación 1.1 no se puede estimar sin supuestos adicionales: cuatro componentes no observados y una sola serie observada. Todo método de descomposición añade restricciones, casi siempre sobre las frecuencias que ocupa cada componente o sobre la forma de su dinámica. Dos métodos razonables dan resultados distintos, y ninguno es “el” verdadero. Lo que se puede exigir es que el supuesto sea explícito y que el resultado se reporte junto con él.
La separación no es igual de difícil en todos los componentes. La estacionalidad ocupa frecuencias conocidas, se repite y es la parte mejor identificada del problema; separar tendencia de ciclo, en cambio, es una decisión casi puramente teórica, con una literatura entera en desacuerdo: el filtro de Hodrick y Prescott (1997), la crítica de Hamilton (2018), la descomposición de Beveridge y Nelson (1981) y los modelos de componentes no observados de Harvey (1989) producen ciclos distintos con los mismos datos. El Capítulo 8 trata ese problema. Este capítulo se ocupa del componente estacional, donde el acuerdo es mucho mayor.
Vale la pena ver el problema con una serie inventada, donde sí conocemos la respuesta.
rng = np.random.default_rng(7)
T = 240
index = pd.period_range("2006-01", periods=T, freq="M")

trend = np.log(100) + 0.0025 * np.arange(T)
cycle = np.zeros(T)
for t in range(2, T):
    cycle[t] = (1.5 * cycle[t - 1] - 0.6 * cycle[t - 2]
                + rng.normal(0, 0.004))
pattern = np.array([-1.2, -1.8, 2.8, 0.6, 0.2, -0.4,
                    0.9, 0.4, -0.3, 0.1, -0.8, -0.5]) / 100
pattern = pattern - pattern.mean()
season = pattern[np.arange(T) % 12]
irregular = rng.normal(0, 0.004, T)

log_y = trend + cycle + season + irregular
y_sim = pd.Series(np.exp(log_y), index=index.to_timestamp())

size = figsize(0.52)
fig, axes = plt.subplots(2, 2, sharex=True, figsize=size)
pieces = [(log_y, "serie (en logaritmos)"),
          (trend + cycle, "tendencia y ciclo"),
          (season, "estacional"),
          (irregular, "irregular")]
for ax, (values, title) in zip(axes.ravel(), pieces):
    ax.plot(y_sim.index, values, color=PALETTE["ink"], lw=0.9)
    ax.set_title(title, fontsize=8.5)
plt.show()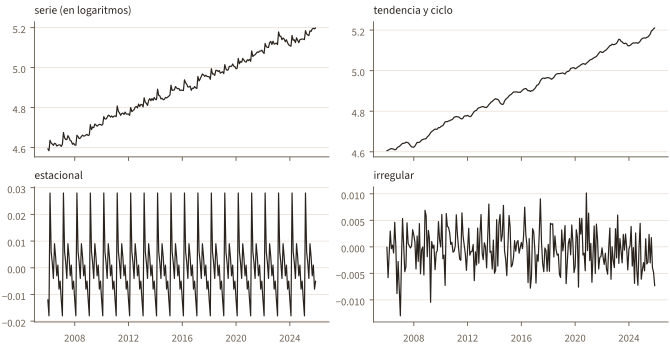
1.3 Ajuste estacional
La estacionalidad es un fenómeno económico real: en diciembre se produce y se compra más, en marzo empiezan las clases, la pesca depende de las vedas. No es un error de medición. El problema es que domina la variación de corto plazo, como se vio en la Sección 1.1, y esconde justamente lo que interesa: si la economía se está acelerando o desacelerando ahora. Ajustar por estacionalidad es estimar ese componente y restarlo de la serie.
from MacroPy import seasonal_adjust

adjusted = seasonal_adjust(gdp_pe, method="x13", outlier=True)
gdp_pe_sa = pd.Series(adjusted.seasadj.values,
                      index=gdp_pe.index)

fig, axes = plt.subplots(1, 2, figsize=figsize(0.40),
                         gridspec_kw={"width_ratios": [1.5, 1]})
windows = [slice(None), slice("2017", "2023")]
for ax, window in zip(axes, windows):
    dates = gdp_pe[window].index.to_timestamp(how="end")
    ax.plot(dates, gdp_pe[window] / 1000, lw=0.9,
            color=PALETTE["muted"], label="sin ajustar")
    ax.plot(dates, gdp_pe_sa[window] / 1000, lw=1.3,
            color=PALETTE["accent"], label="desestacionalizado")
charts.year_ticks(axes[0], every=10)
charts.year_ticks(axes[1], every=2)
charts.legend_outside(axes[0], ncol=2)
plt.show()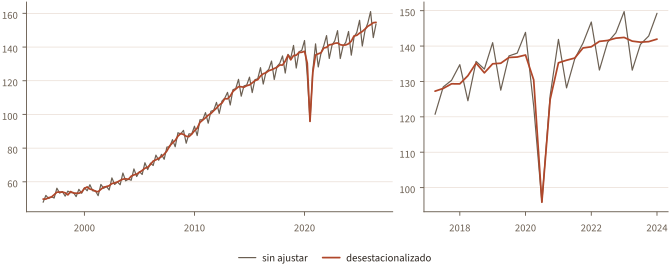
factor = 100 * np.log(gdp_pe / gdp_pe_sa)
first = factor[factor.index.quarter == 1]
print("factor medio por trimestre (%):",
      factor.groupby(factor.index.quarter).mean().round(1)
      .to_dict())
print(f"primer trimestre: {first.iloc[0]:.1f} % en "
      f"{first.index[0].year}, {first.iloc[-1]:.1f} % en "
      f"{first.index[-1].year}")
factor medio por trimestre (%): {1: -4.8, 2: 2.1, 3: -0.2, 4: 2.8}
primer trimestre: -3.8 % en 1996, -5.9 % en 2026El factor estacional estimado es grande: en promedio, el primer trimestre está 4.8 % por debajo de lo que dicta la tendencia y el cuarto, 2.8 % por encima. Y no es fijo: el factor del primer trimestre pasa de \(-3.8\) % en 1996 a \(-5.9\) % en 2026, a medida que cambia la estructura productiva. Por eso ajustar no es restar la media de cada trimestre, que es lo que haría una regresión con variables dummy estacionales.
Cómo funciona
Los programas que usan las oficinas de estadística siguen la misma receta de dos pasos.
Primero, limpiar. Antes de buscar el patrón estacional se quitan los efectos que lo contaminarían: el número de días hábiles, Semana Santa, que cae en marzo o en abril, los feriados y los valores atípicos, como el segundo trimestre de 2020. Se hace con una regresión con errores ARIMA estacionales, llamada regARIMA:
\[ \ln y_t = \beta' x_t + z_t, \qquad \phi(L)\Phi(L^{s})(1-L)^d(1-L^{s})^D z_t = \theta(L)\Theta(L^{s}) a_t , \tag{1.2}\]
donde \(x_t\) reúne esos regresores y \(s\) es el número de periodos por año. El mismo modelo pronostica la serie hacia adelante, para que los promedios del segundo paso no se queden sin datos al final de la muestra, que es justamente el tramo que más interesa.
Segundo, separar. Con la serie limpia se estima el componente estacional, de una de dos maneras. Con filtros (X-11): se quita la tendencia con un promedio móvil, y el factor de cada trimestre se estima promediando ese mismo trimestre en los años vecinos, de modo que puede cambiar lentamente. Con un modelo (SEATS): a partir del ARIMA estimado se deduce qué parte de la dinámica es estacional, y se extrae con el filtro que minimiza el error cuadrático medio.
El factor del primer trimestre según X-11 es, en esencia, un promedio de los primeros trimestres de los años cercanos, medidos contra la tendencia. SEATS llega a algo parecido por otro camino: en lugar de fijar los promedios de antemano, los deduce del modelo, y por eso puede decir además cuán incierto es el componente estimado.
Las dos implementaciones estándar son X-13ARIMA-SEATS, de la Oficina del Censo de Estados Unidos (Findley et al. 1998), y TRAMO-SEATS, del Banco de España (Gómez y Maravall 1996). Ambas hacen los dos pasos y la diferencia es de origen: X-13 desciende del X-11 de los años sesenta (Dagum 1980) e incorporó después SEATS, mientras que TRAMO-SEATS nació del lado de los modelos y da más libertad para definir el calendario de cada país. Las directrices europeas (Eurostat 2024) aceptan las dos familias, y la plataforma JDemetra+ las implementa juntas. seasonal_adjust de MacroPy ejecuta X-13 con los filtros X-11.
Que la separación estacional esté bien identificada se puede comprobar con la serie simulada de la Figura 1.2, donde el patrón verdadero es conocido.
check = seasonal_adjust(y_sim, method="x13", outlier=True)
found = 100 * np.log(y_sim / check.seasadj)
by_month = found.groupby(found.index.month).mean().values
error = np.abs(by_month - 100 * pattern).mean()
corr = np.corrcoef(by_month, pattern)[0, 1]
print(f"error medio: {error:.2f} puntos; "
      f"correlación: {corr:.3f}")
error medio: 0.10 puntos; correlación: 0.995X-13 recupera el patrón con un error medio de una décima de punto porcentual y una correlación de 0.995 con el verdadero.
La variación interanual no es un ajuste
La alternativa gratuita es comparar contra el mismo trimestre del año anterior. Elimina la estacionalidad, pero promedia cuatro trimestres, de modo que llega tarde a los quiebres, y arrastra lo que pasó hace un año: el llamado efecto base.
yoy = 100 * (gdp_pe / gdp_pe.shift(4) - 1)
qoq_sa = 100 * (gdp_pe_sa / gdp_pe_sa.shift(1) - 1)
two_years = 100 * (gdp_pe_sa / gdp_pe_sa.shift(8) - 1)
print(f"2021T2: interanual {yoy['2021Q2']:.1f} %, "
      f"log {100 * np.log1p(yoy['2021Q2'] / 100):.1f}")
print(f"2021T2 ajustado: {qoq_sa['2021Q2']:.1f} % contra "
      f"2021T1, {two_years['2021Q2']:.1f} % contra 2019T2")

adj_us = seasonal_adjust(gdp_us_nsa, method="x13",
                         outlier=True)
sa_us = pd.Series(adj_us.seasadj.values,
                  index=gdp_us_nsa.index)
q_us = pd.DataFrame(
    {"sin ajustar": 100 * gdp_us_nsa.pct_change(),
     "ajustado": 100 * sa_us.pct_change()})
print(q_us.loc["2020Q1":"2020Q2"].round(1))
print("mayor caída ajustada:", q_us["ajustado"].idxmin())
print("Perú ajustado, 2020T2 y 2020T3 (%):",
      qoq_sa["2020Q2":"2020Q3"].round(1).tolist())
2021T2: interanual 42.1 %, log 35.1
2021T2 ajustado: 0.5 % contra 2021T1, -0.1 % contra 2019T2
sin ajustar ajustado
date
2020Q1 -5.5 -1.1
2020Q2 -5.4 -7.7
mayor caída ajustada: 2020Q2
Perú ajustado, 2020T2 y 2020T3 (%): [-26.5, 30.3]En el segundo trimestre de 2021 el PBI peruano creció 42.1 % interanual, una cifra histórica. La serie desestacionalizada de la Figura 1.3 cuenta otra cosa: el nivel era prácticamente el de dos años antes (\(-0.1\) %) y había crecido 0.5 % respecto del trimestre anterior. La interanual comparaba contra el peor trimestre del confinamiento y hablaba, sobre todo, del pasado.
El error opuesto es mirar la variación trimestral sin ajustar. El PBI de Estados Unidos sin ajustar, que la BEA publica desde 2002, cae 5.5 % en el primer trimestre de 2020 y 5.4 % en el segundo; ajustado, cae 1.1 y 7.7 %. Sin ajustar, los dos trimestres parecen igual de malos; ajustado, uno es una desaceleración y el otro la caída más grande de la muestra.
Usar la variación interanual como si fuera una desestacionalización es un error frecuente. La diferencia de un año elimina el patrón estacional, pero introduce una media móvil que crea autocorrelación artificial, desplaza los puntos de quiebre y arrastra los efectos base. Para describir la coyuntura, la serie desestacionalizada; para comparar con el año anterior, la interanual, sabiendo lo que mide.
Otros métodos. Las variables dummy estacionales son la opción más simple y la peor: imponen el mismo factor todos los años, y el primer trimestre peruano muestra que no lo es. STL (Cleveland et al. 1990) estima el patrón con regresiones locales, es robusto a atípicos y está en statsmodels (method="stl" en MacroPy), pero no trata el calendario. Los modelos de componentes no observados estiman la estacionalidad junto con la tendencia y el ciclo con el filtro de Kalman (Harvey 1989); es la opción natural cuando el ajuste es parte del modelo y no un paso previo, y es lo que hace el Capítulo 7.
1.4 Transformaciones
Elegir la transformación es elegir qué pregunta se puede responder después. Las opciones usuales son pocas.
| Transformación | Fórmula | Qué preserva |
|---|---|---|
| Nivel | \(y_t\) | todo, incluida la tendencia |
| Logaritmo | \(\ln y_t\) | la tendencia, en escala proporcional |
| Diferencia logarítmica | \(\Delta \ln y_t\) | la dinámica de corto plazo |
| Tasa interanual | \(y_t/y_{t-s} - 1\) | el movimiento de baja frecuencia |
| Diferencia de orden \(s\) | \(\Delta_s \ln y_t\) | la dinámica sin estacionalidad |
La primera decisión, niveles frente a diferencias, se discute en el Sección 3.10: la respuesta depende de si interesan las relaciones de largo plazo y de si las series comparten tendencias estocásticas (Nelson y Plosser 1982). La segunda, que es la de esta sección, es si trabajar con la variable o con su logaritmo.
Por qué logaritmos
Hay cuatro razones.
Linealiza el crecimiento. Una serie que crece a tasa constante es una recta en logaritmos, y un cambio de tendencia se ve en esa escala y se esconde en la de niveles.
Su diferencia es casi la tasa de crecimiento. Con \(g_t = \Delta y_t / y_{t-1}\), basta sumar y restar uno dentro del logaritmo:
\[ \begin{aligned} \Delta \ln y_t &= \ln y_t - \ln y_{t-1} = \ln \frac{y_t}{y_{t-1}} \\ &= \ln\left(1 + \frac{y_t}{y_{t-1}} - \frac{y_{t-1}}{y_{t-1}}\right) \\ &= \ln\left(1 + \frac{y_t - y_{t-1}}{y_{t-1}}\right) = \ln(1 + g_t) \\ &= g_t - \frac{g_t^2}{2} + \frac{g_t^3}{3} - \cdots \approx g_t . \end{aligned} \tag{1.3}\]
La última igualdad es la expansión de Taylor de \(\ln(1+g)\) alrededor de cero: si \(g\) es pequeña, los términos de orden dos en adelante son despreciables. Si \(y\) pasa de 100 a 105, la tasa es 0.05 y \(\ln 1.05 = 0.0488\); si pasa de 100 a 140, la tasa es 0.40 y \(\ln 1.40 = 0.3365\). El 42.1 % interanual del PBI peruano de 2021 es 35.1 en diferencia logarítmica: con tasas así hay que decir cuál se reporta.
grid = np.linspace(-0.45, 0.9, 300)

fig, ax = plt.subplots(figsize=figsize(0.55))
ax.plot(grid, grid, color=PALETTE["muted"], lw=1.0,
        ls=(0, (4, 2)), label="$g$ (45 grados, orden 1)")
ax.plot(grid, grid - grid**2 / 2, color=PALETTE["steel"],
        lw=1.0, ls=(0, (1, 1.5)), label="$g - g^2/2$ (orden 2)")
ax.plot(grid, np.log1p(grid), color=PALETTE["ink"], lw=1.4,
        label="$\\ln(1+g)$")
for g, text in [(0.05, "105/100"), (0.40, "140/100")]:
    ax.plot([g, g], [np.log1p(g), g], color=PALETTE["accent"],
            lw=1.2, marker="o", ms=3)
    ax.annotate(text, (g, np.log1p(g)), xytext=(6, -12),
                textcoords="offset points", fontsize=8,
                color=PALETTE["accent"])
charts.zero_line(ax)
ax.axvline(0, color=PALETTE["ink"], lw=0.7, zorder=1)
ax.set_xlabel("tasa de crecimiento $g$")
ax.set_ylabel("diferencia logarítmica")
charts.legend_outside(ax, ncol=3)
plt.show()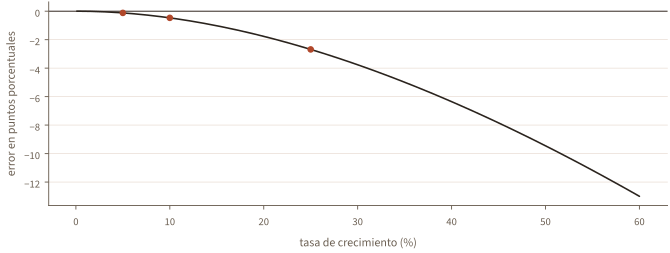
La curva queda bajo la recta a ambos lados de cero: el logaritmo subestima las subidas y exagera las caídas. Por eso una caída de 50 % seguida de una subida de 100 % suma cero en logaritmos, igual que en niveles, mientras que las tasas sumarían 50 %.
Se suma. El crecimiento logarítmico de un año es la suma de los cuatro trimestrales, y anualizar es multiplicar por cuatro; con tasas ordinarias hay que multiplicar factores.
Suele estabilizar la varianza. Si la amplitud de las fluctuaciones crece con el nivel, los cambios en logaritmos tienen varianza aproximadamente constante (el caso \(\lambda = 0\) de la familia de Box y Cox (1964)), y una estacionalidad multiplicativa se vuelve aditiva.
def sd_growth(level, first, second):
    out = {}
    for scale, change in [("niveles", level.diff()),
                          ("logaritmos", np.log(level).diff())]:
        change = change.drop(change["2020":"2021"].index)
        ratio = change[second:].std() / change[:first].std()
        out[scale] = round(100 * (ratio - 1))
    return out


print("Perú, 2011-2026 contra 1996-2010 (%):",
      sd_growth(gdp_pe, "2010", "2011"))
print("EE.UU., 2014-2026 contra 2002-2013 (%):",
      sd_growth(gdp_us_nsa, "2013", "2014"))
Perú, 2011-2026 contra 1996-2010 (%): {'niveles': 98, 'logaritmos': 2}
EE.UU., 2014-2026 contra 2002-2013 (%): {'niveles': 49, 'logaritmos': 16}En el PBI peruano sin ajustar, y dejando fuera 2020 y 2021, la desviación estándar de la variación trimestral es 98 % mayor en 2011-2026 que en 1996-2010 medida en soles, y sólo 2 % mayor medida en logaritmos. Pero es una hipótesis que se contrasta serie por serie, no una propiedad del logaritmo: en el PBI de Estados Unidos la misma comparación da 49 y 16 %.
Una advertencia para pronosticar: la exponencial de la media de un logaritmo es la mediana del nivel, no su media, y la diferencia importa cuando la varianza es grande (Lütkepohl y Xu 2012).
El logaritmo exige variables positivas, y eso descarta más series de las que parece: saldos fiscales, cuenta corriente, brechas y cualquier tasa que pueda ser negativa. Forzar un logaritmo sumando una constante arbitraria cambia la interpretación de los coeficientes y no resuelve nada.
Qué transformación usa cada quien
Conviene mirar qué hacen los artículos que el libro replica, porque la elección no es arbitraria.
| Artículo | Variables | Transformación |
|---|---|---|
| Sims (1980) | producto, precios, dinero, tasas | logaritmos en niveles |
| Blanchard y Quah (1989) | PBI, desempleo | tasa de crecimiento, desempleo sin tendencia |
| Stock y Watson (2001) | inflación, desempleo, tasa | \(400\,\Delta \ln P_t\); tasas en niveles |
| Uhlig (2005) | PBI, deflactor, reservas, tasa | \(100 \ln\) en niveles; tasa en nivel |
| Bańbura et al. (2010) | 131 series | logaritmos en niveles, con prior de Minnesota |
El patrón es claro. Cuando el objetivo es estructural, es decir estimar respuestas a choques, la práctica dominante es trabajar en logaritmos de los niveles y dejar que los rezagos capturen la persistencia, tal como argumentan Sims et al. (1990). Cuando el objetivo es pronosticar y las series tienen raíces cercanas a uno, se diferencia, o se encoge hacia una caminata aleatoria con el prior del Capítulo 5, que es una forma más suave de hacer lo mismo. Las tasas de interés y de desempleo se dejan en niveles siempre, porque ya están acotadas y su logaritmo no tiene interpretación útil.
La regla operativa cabe en tres líneas. Si la variable es un índice o un valor que crece de forma multiplicativa, logaritmo. Si es una tasa o un porcentaje, nivel. Si el modelo va a leerse como elasticidades o como respuestas porcentuales a un choque, logaritmo otra vez, porque es lo que hace que los coeficientes tengan esa lectura.
1.5 De dónde vienen los datos
Ningún dato macroeconómico se observa directamente. El PBI no se mide: se estima, combinando censos, encuestas, registros administrativos y supuestos de imputación, y se publica como un índice encadenado cuya unidad depende del año base. La inflación no es el cambio de “los precios” sino el de una canasta fija durante un tiempo, con sustituciones y ajustes de calidad que son decisiones metodológicas. Entre el concepto del modelo y la serie que entra al código hay una cadena de convenciones, y tres de sus consecuencias atraviesan el libro.
La primera es que el nivel casi nunca es comparable y la tasa casi siempre sí. Un índice con base 2007 = 100 no dice nada por sí solo; su tasa de crecimiento se compara entre países y épocas.
La segunda es que los datos se revisan. La primera estimación del PBI de un trimestre se publica con semanas de retraso y se corrige durante años, de modo que un pronóstico evaluado con los datos de hoy usa información que su autor no tenía (Croushore y Stark 2001).
La tercera es que una serie puede ser en parte construida. En Estados Unidos las cuentas nacionales son trimestrales y el PBI mensual no existe como estadística oficial; las series mensuales de PBI que usan muchos VAR, como la de Uhlig (2005), interpolan el dato trimestral con indicadores mensuales, y su variación de un mes a otro es en parte producto del método. Eso no las invalida, pero obliga a no leer un movimiento mensual aislado como si fuera un dato.
Descarga reproducible
La regla del libro es simple: data/raw/ es inmutable y todo lo demás se reconstruye con un script. Ninguna serie se edita a mano, y ningún resultado depende de un archivo que sólo existe en la computadora de quien escribe. Las series de este capítulo se descargan así:
from urllib.request import urlretrieve

from MacroPy import get_bcrp_data

FRED = "https://fred.stlouisfed.org/graph/fredgraph.csv?id="
for code in ["DEXUSEU", "HOUSTNSA", "FEDFUNDS", "ND000334Q"]:
    urlretrieve(FRED + code, f"data/raw/fred_{code}.csv")

peru = get_bcrp_data({"PN02538AQ": "pbi"}, frequency="Q",
                     start_period="1996-1")
FRED entrega sus series como CSV sin necesidad de registrarse, y get_bcrp_data de MacroPy consulta la API del BCRP. Esa celda no se ejecuta al compilar el libro, a propósito. Los archivos que produce están guardados en data/raw/, de modo que el libro se compila sin conexión y los resultados no cambian cuando la fuente revisa el pasado. Para actualizar, se corre la descarga y se vuelve a compilar: la diferencia entre las dos versiones es exactamente la revisión de los datos.
1.6 Otros temas
Revisiones y datos en tiempo real
Las bases de datos de vintages, como ALFRED de la Reserva Federal de San Luis, guardan lo que se publicó en cada fecha. Un ejercicio de pronóstico honesto usa, en cada momento, sólo lo que estaba disponible entonces (Croushore y Stark 2001). La diferencia no es menor: las primeras estimaciones del PBI se revisan en varias décimas, y con series muy revisadas la evaluación con datos finales exagera la calidad del pronóstico.
Valores atípicos y la pandemia
El PBI peruano desestacionalizado cae 26.5 % en el segundo trimestre de 2020 y sube 30.3 % en el tercero. Un modelo lineal con errores gaussianos estimado sobre esa muestra interpreta esos trimestres como evidencia sobre la dinámica normal de la economía, y el resultado es una varianza sobreestimada y unos coeficientes deformados. Las opciones son tratarlos como atípicos con variables dummy, escalar la volatilidad de esos periodos (Lenza y Primiceri 2022), excluir el tramo o modelar la volatilidad cambiante como en el Capítulo 9. Ninguna es gratis, y lo mínimo es decir cuál se usó.
Frecuencias y agregación
Pasar de mensual a trimestral parece inocuo y no lo es. Un promedio de tres meses no es lo mismo que el dato de fin de trimestre: el promedio suaviza y crea autocorrelación, el fin de periodo conserva el ruido. Para variables de flujo, como el PBI, corresponde promediar o sumar; para variables de saldo, como una tasa de interés o el tipo de cambio, el promedio y el fin de periodo responden preguntas distintas y la elección debe declararse. Los capítulos siguientes trabajan con series ya agregadas por la fuente y no re-agregan nada, precisamente para no añadir una decisión propia a las que la fuente ya tomó.
Ideas clave
- Las series macroeconómicas difieren en frecuencia, tendencia y dinámica de corto plazo. Sus niveles son casi siempre muy persistentes; sus cambios, mucho menos.
- La descomposición en tendencia, ciclo, estacionalidad e irregular necesita supuestos: la parte estacional está bien identificada, la separación entre tendencia y ciclo no.
- En una serie sin ajustar el calendario domina el corto plazo. El ajuste estacional lo remueve en dos pasos, limpiar calendario y atípicos y luego separar un patrón que cambia lentamente.
- La variación interanual no reemplaza al ajuste: llega tarde a los quiebres y arrastra efectos base, como muestra el Perú de 2021.
- El logaritmo se usa porque linealiza el crecimiento, aproxima la tasa cuando es pequeña y se suma; que estabilice la varianza es una hipótesis que hay que contrastar serie por serie.
Lecturas recomendadas
- Ghysels y Osborn (2001)
- el tratamiento econométrico completo de la estacionalidad.
- Findley et al. (1998)
- la descripción oficial del programa X-12-ARIMA, base del X-13 actual.
- Gómez y Maravall (1996)
- el manual de TRAMO-SEATS, con la lógica de extracción de señal basada en modelos.
- Eurostat (2024)
- las directrices europeas de ajuste estacional; el documento que siguen las oficinas de estadística.
- Lütkepohl y Xu (2012)
- qué gana y qué pierde el pronóstico al tomar logaritmos.
Ejercicios
Ejercicio 1.1 Reproduzca la simulación de la Figura 1.2 con una estacionalidad cuya amplitud crece 2 % por año. Desestacionalice con X-13 y con STL y compare cuál sigue mejor el cambio de patrón.
Ejercicio 1.2 Tome la serie mensual del IPC peruano y calcule la inflación de tres maneras: interanual, mensual anualizada sobre la serie observada y mensual anualizada sobre la desestacionalizada. Grafique las tres desde 2020 y explique cuál habría sido más útil para decidir la tasa de política en cada momento.
Ejercicio 1.3 Desestacionalice la tasa de desempleo de Estados Unidos con seasonal_adjust (interpole antes el dato faltante de octubre de 2025) y estime el factor de cada mes en dos submuestras, 2000-2012 y 2013-2026. ¿Cambió el patrón? Relacione el resultado con el argumento contra las variables dummy estacionales.
Ejercicio 1.4 Verifique numéricamente la Ecuación 1.3: para las tasas interanuales del PBI peruano, calcule la diferencia entre \(\ln(1+g_t)\) y \(g_t\) y encuentre a partir de qué tasa el error supera un punto porcentual. Compare el resultado con el que predice el término \(g^2/2\).
Ejercicio 1.5 Construya la serie trimestral del PBI peruano a partir del índice mensual desestacionalizado de dos maneras, promediando los meses y tomando el último mes de cada trimestre. Estime un AR(4) sobre la tasa de crecimiento de cada una y compare la persistencia estimada. ¿Cuánto de lo que se lee como dinámica económica es consecuencia de la agregación?